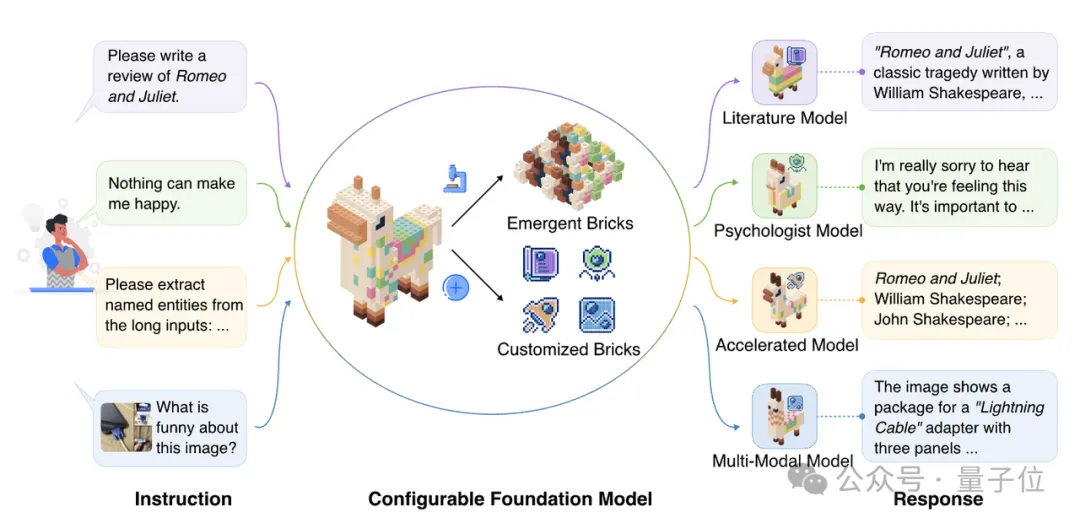
清华团队革新MoE架构!像搭积木一样构建大模型,提出新型类脑稀疏模块化架构
清华团队革新MoE架构!像搭积木一样构建大模型,提出新型类脑稀疏模块化架构探索更高效的模型架构, MoE是最具代表性的方向之一。 MoE架构的主要优势是利用稀疏激活的性质,将大模型拆解成若干功能模块,每次计算仅激活其中一小部分,而保持其余模块不被使用,从而大大降低了模型的计算与学习成本,能够在同等计算量的情况下产生性能优势。
来自主题: AI技术研报
5375 点击 2024-11-01 17:11

 搜索
探索更高效的模型架构, MoE是最具代表性的方向之一。 MoE架构的主要优势是利用稀疏激活的性质,将大模型拆解成若干功能模块,每次计算仅激活其中一小部分,而保持其余模块不被使用,从而大大降低了模型的计算与学习成本,能够在同等计算量的情况下产生性能优势。
比传统MoE推理速度更快、性能更高的新一代架构,来了! 这个通用架构叫做MoE++,由颜水成领衔的昆仑万维2050研究院与北大袁粒团队联合提出。

鹅厂新一代旗舰大模型混元Turbo技术报告首次曝光。模型采用全新分层异构的MoE架构,总参数达万亿级别,性能仅次于GPT-4o,位列国内第一梯队。
轻量级模型的春天要来了吗?
前几天,普林斯顿大学联合Meta在arXiv上发表了他们最新的研究成果——Lory模型,论文提出构建完全可微的MoE模型,是一种预训练自回归语言模型的新方法。
今年以来,苹果显然已经加大了对生成式人工智能(GenAI)的重视和投入。此前在 2024 苹果股东大会上,苹果 CEO 蒂姆・库克表示,今年将在 GenAI 领域实现重大进展。此外,苹果宣布放弃 10 年之久的造车项目之后,一部分造车团队成员也开始转向 GenAI。
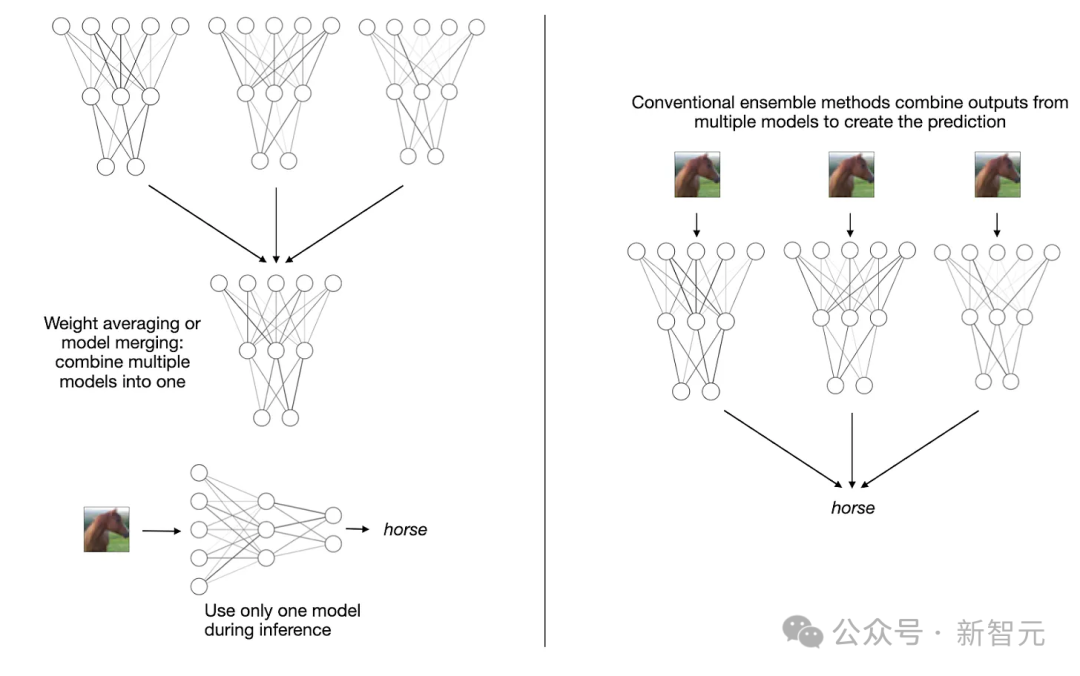
AI大模型并非越大越好?过去一个月,关于大模型变小的研究成为亮点,通过模型合并,采用MoE架构都能实现小模型高性能。
「天工AI」国内首个MoE架构免费向C端用户开放的大语言模型应用全新问世。