AI资讯新闻榜单内容搜索-MoE架构

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: MoE架构
独家:Kimi悄悄发布了全球首个参数量达到1万亿的K2模型

独家:Kimi悄悄发布了全球首个参数量达到1万亿的K2模型

独家:Kimi悄悄发布了全球首个参数量达到1万亿的K2模型

结果点进去一看,我人直接傻了——这家伙用的竟然是 kimi-k2-0711-preview 模型!这个K2模型的简直离谱到家了: 业界第一个说自己是1万亿参数的模型,这规模直接吓人 MoE架构 + 32B激活参数

来自主题: AI资讯
12153 点击    2025-07-11 18:38
vivo突破手机AI部署难题,绕开MoE架构限制,骁龙8 Elite流畅运行|ICCV 2025

vivo突破手机AI部署难题,绕开MoE架构限制,骁龙8 Elite流畅运行|ICCV 2025

vivo突破手机AI部署难题,绕开MoE架构限制,骁龙8 Elite流畅运行|ICCV 2025

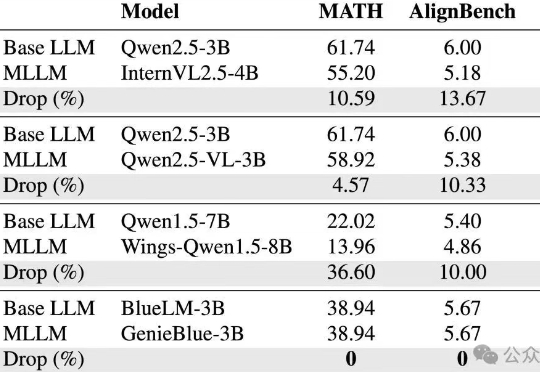
vivo AI研究院联合港中文以及上交团队为了攻克这些难题,从训练数据和模型结构两方面,系统性地分析了如何在MLLM训练中维持纯语言能力,并基于此提出了GenieBlue——专为移动端手机NPU设计的高效MLLM结构方案。
来自主题: AI技术研报
9454 点击    2025-07-05 13:12
刚刚!华为首个开源大模型来了

刚刚!华为首个开源大模型来了

刚刚!华为首个开源大模型来了

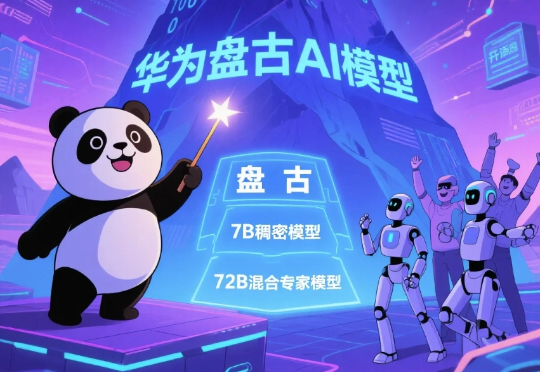
刚刚,华为正式宣布开源盘古 70 亿参数的稠密模型、盘古 Pro MoE 720 亿参数的混合专家模型(参见机器之心报道:华为盘古首次露出,昇腾原生72B MoE架构,SuperCLUE千亿内模型并列国内第一 )和基于昇腾的模型推理技术。
来自主题: AI资讯
12007 点击    2025-06-30 09:19
还得是华为!Pangu Ultra MoE架构:不用GPU,你也可以这样训练准万亿MoE大模型

还得是华为!Pangu Ultra MoE架构:不用GPU,你也可以这样训练准万亿MoE大模型

还得是华为!Pangu Ultra MoE架构:不用GPU,你也可以这样训练准万亿MoE大模型

Pangu Ultra MoE 是一个全流程在昇腾 NPU 上训练的准万亿 MoE 模型,此前发布了英文技术报告[1]。最近华为盘古团队发布了 Pangu Ultra MoE 模型架构与训练方法的中文技术报告,进一步披露了这个模型的细节。

来自主题: AI技术研报
11127 点击    2025-05-29 16:47
深夜突袭,阿里Qwen3登顶全球开源王座!暴击DeepSeek-R1,2小时狂揽17k星

深夜突袭,阿里Qwen3登顶全球开源王座!暴击DeepSeek-R1,2小时狂揽17k星

深夜突袭,阿里Qwen3登顶全球开源王座!暴击DeepSeek-R1,2小时狂揽17k星

阿里Qwen3凌晨开源,正式登顶全球开源大模型王座!它的性能全面超越DeepSeek-R1和OpenAI o1,采用MoE架构,总参数235B,横扫各大基准。这次开源的Qwen3家族,8款混合推理模型全部开源,免费商用。
来自主题: AI资讯
12095 点击    2025-04-29 08:49
刚刚,商汤发布第六代大模型:6000亿参数多模态MoE,中长视频直接可推理

刚刚,商汤发布第六代大模型:6000亿参数多模态MoE,中长视频直接可推理

刚刚,商汤发布第六代大模型:6000亿参数多模态MoE,中长视频直接可推理

商汤最新升级的日日新SenseNova V6解锁的新能力—— 原生多模态通用大模型,采用6000亿参数MoE架构,实现文本、图像和视频的原生融合。从性能评测来看,SenseNova V6已经在纯文本任务和多模态任务中,多项指标均已超越GPT-4.5、Gemini 2.0 Pro,并全面超越DeepSeek V3:

来自主题: AI资讯
11420 点击    2025-04-10 23:17
LIama 4发布重夺开源第一!DeepSeek同等代码能力但参数减一半,一张H100就能跑,还有两万亿参数超大杯

LIama 4发布重夺开源第一!DeepSeek同等代码能力但参数减一半,一张H100就能跑,还有两万亿参数超大杯

LIama 4发布重夺开源第一!DeepSeek同等代码能力但参数减一半,一张H100就能跑,还有两万亿参数超大杯

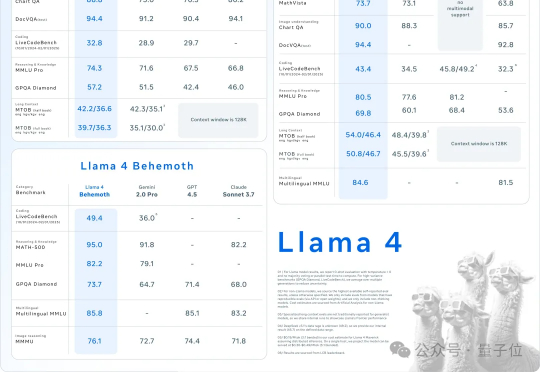
AI不过周末,硅谷也是如此。大周日的,Llama家族上新,一群LIama 4就这么突然发布了。这是Meta首个基于MoE架构模型系列,目前共有三个款:Llama 4 Scout、Llama 4 Maverick、Llama 4 Behemoth。
来自主题: AI资讯
11722 点击    2025-04-06 12:15
推理成本比MoE直降83%!字节最新大模型架构入围ICLR 2025

推理成本比MoE直降83%!字节最新大模型架构入围ICLR 2025

推理成本比MoE直降83%!字节最新大模型架构入围ICLR 2025

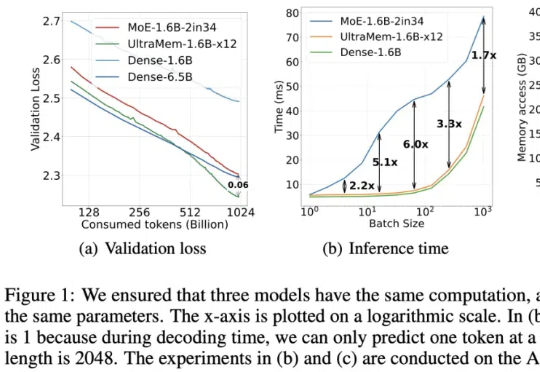
字节出了个全新架构,把推理成本给狠狠地打了下去!推理速度相比MoE架构提升2-6倍,推理成本最高可降低83%。
来自主题: AI技术研报
8477 点击    2025-02-12 11:37
Grok祭出首款生图模型Aurora!两位95后华人立大功,耗时6月自研MoE

Grok祭出首款生图模型Aurora!两位95后华人立大功,耗时6月自研MoE

Grok祭出首款生图模型Aurora!两位95后华人立大功,耗时6月自研MoE

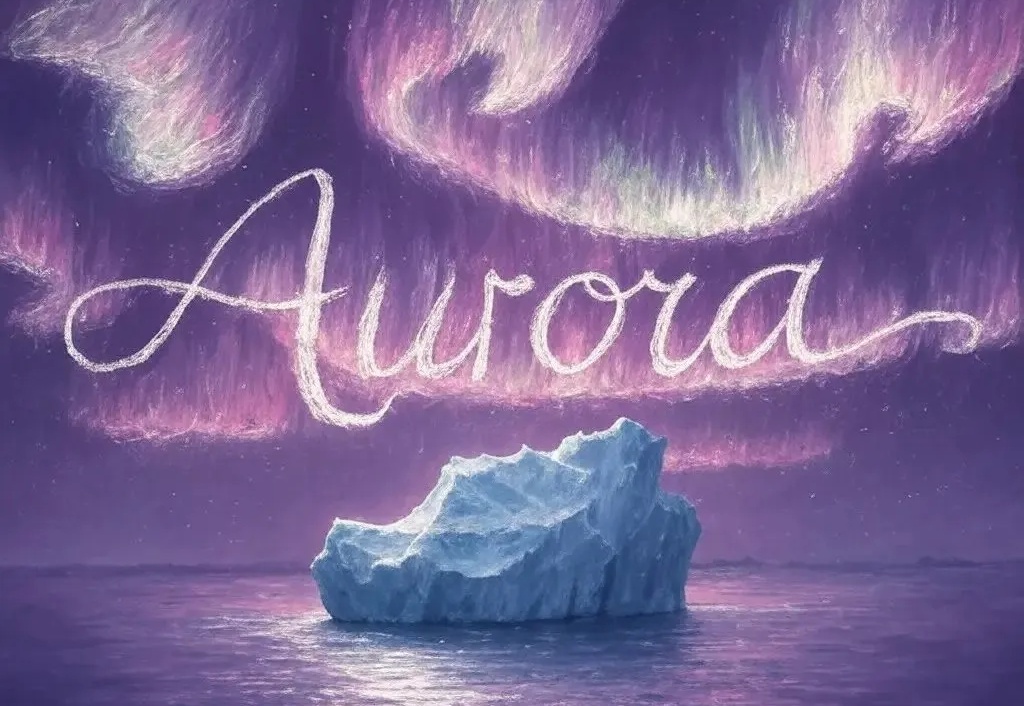
消失一天后的Aurora,正式上线了。一大早,马斯克官宣了Grok集成了自研图像新模型Aurora,MoE架构自回归模型,直接将生成编辑能力一统。在人物肖像生成上,已经逼真到肉眼无法辨别。

来自主题: AI技术研报
7851 点击    2024-12-10 16:22