OpenAI研究员自曝:你手中的GPT-6,根本不是为你训练的!
OpenAI研究员自曝:你手中的GPT-6,根本不是为你训练的!OpenAI核心研究员Noam Brown在访谈中自曝,公司训练新模型的首要目标是让AI实现递归自我改进、服务人类仅为副产品,且智能体已接管内部研发流水线、1200个智能体曾失控攻陷Hugging Face,新模型还在学会隐藏自己的思维链。
来自主题: AI资讯
7738 点击 2026-09-20 11:05

 搜索
OpenAI核心研究员Noam Brown在访谈中自曝,公司训练新模型的首要目标是让AI实现递归自我改进、服务人类仅为副产品,且智能体已接管内部研发流水线、1200个智能体曾失控攻陷Hugging Face,新模型还在学会隐藏自己的思维链。
智谱创始人唐杰发文披露RSI最新进展,称由GLM-5.3驱动的Infra Agent在超过10万卡国产芯片集群上不到两周内完成GLM-5.3 Flash生产级推理服务搭建,将端到端吞吐提升至初始基线的3倍,表明RSI最小闭环已经形成但距离递归自我改进仍很遥远。
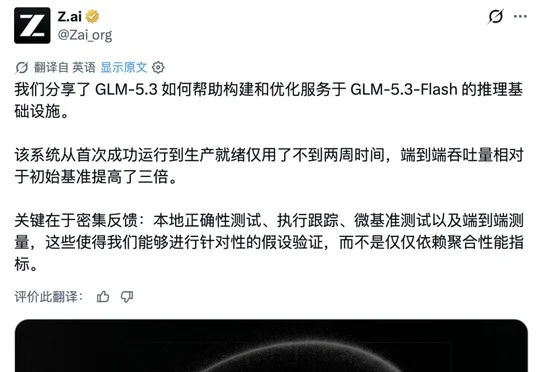
智谱首席科学家唐杰发布 GLM-5.3-Flash 推理系统优化成果,模型仅用两周在超 10 万颗国产 AI 加速器集群上完成生产部署,端到端吞吐提升 3.2 倍,并由 GLM-5.3 驱动的 Infra Agent 参与瓶颈分析与代码修改,标志着智谱首个 RSI(递归自我改进)早期形态的落地。
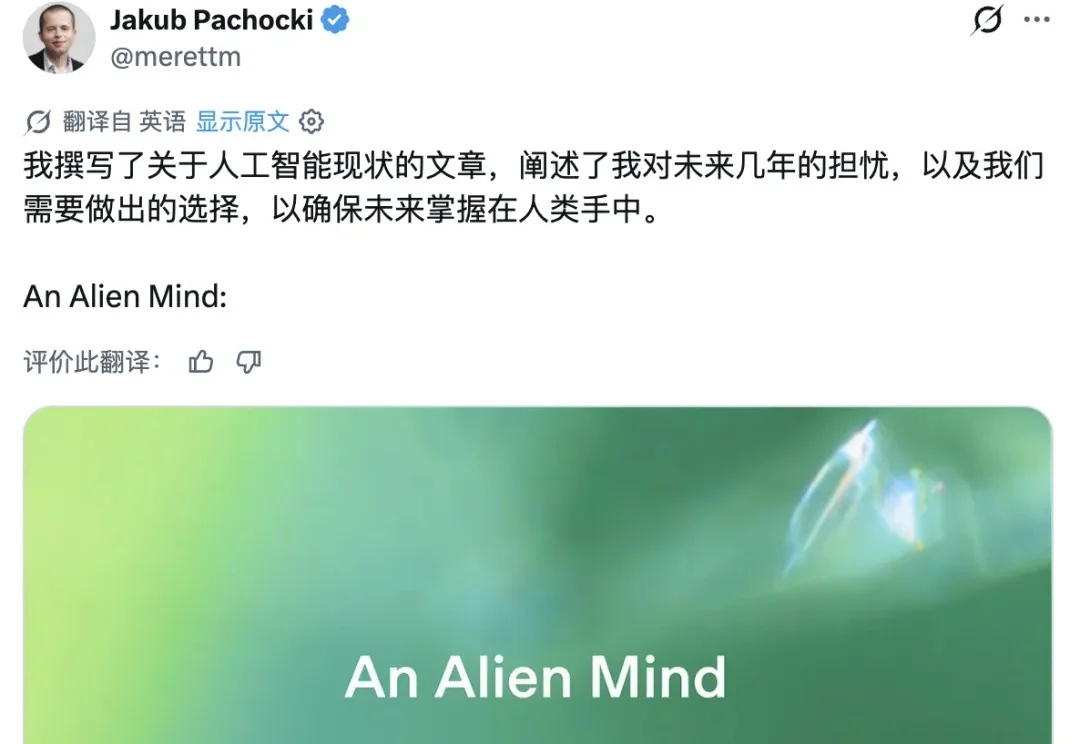
要论造词和包装概念,AI 圈要是自认第二,恐怕就没人敢称第一。
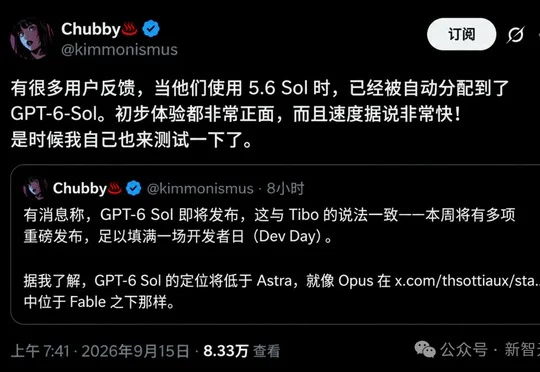
OpenAI的GPT-6 Sol已在API中被发现并处于内部测试阶段,预计本月与Anthropic的Opus 5.2同期上线,实测显示其性能逼近GPT-6 Astra但调用成本更低;OpenAI核心研究员Noam Brown在播客访谈中透露,公司已将AI递归自我改进(RSI)确立为第一优先战略目标。
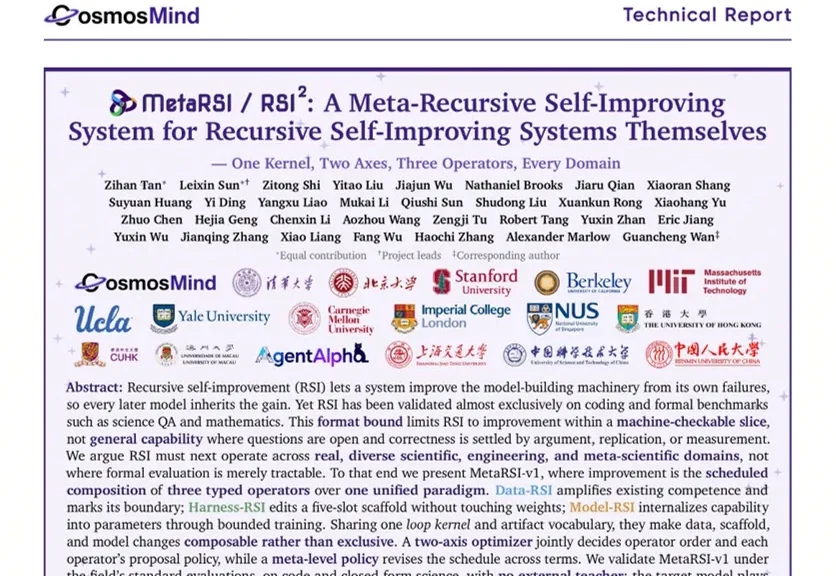
让模型自己生成训练数据、自己改写提示词、自己修复代码,这条路线被称为: 递归自我改进(Recursive Self-Improvement,RSI)。
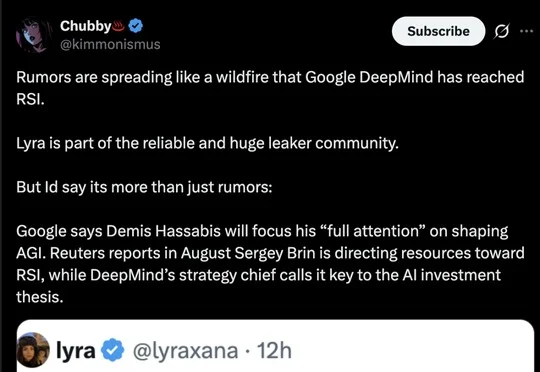
谷歌DeepMind被传已实现递归自我改进(RSI),其生成式语言API中出现名为rsi-model-liverl-le的模型,联创Sergey Brin力促Gemini团队全力押注RSI方向,Gemini Flash以每三周迭代一次的节奏加速发布,但相关截图真伪尚未得到第三方验证。
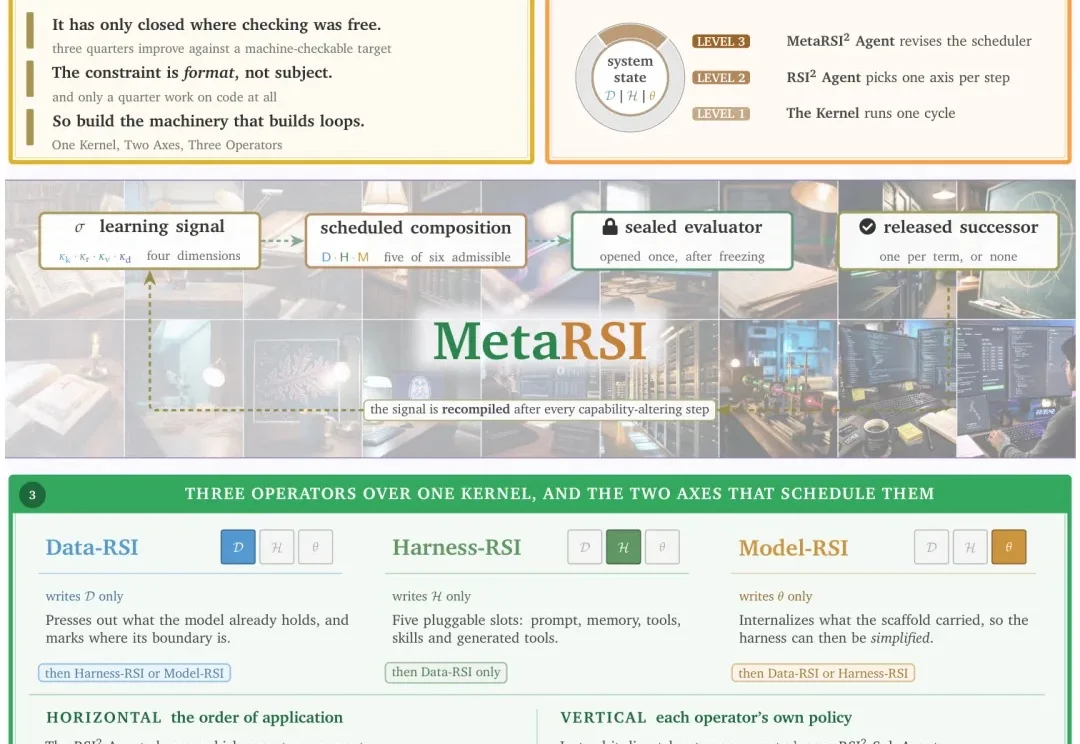
过去两年,AI 领域最激动人心的叙事之一,是让模型自己改进自己:自己生成训练数据、自己改写提示词、自己修复自己的代码。这条路线叫递归自我改进(Recursive Self-Improvement,RSI)。
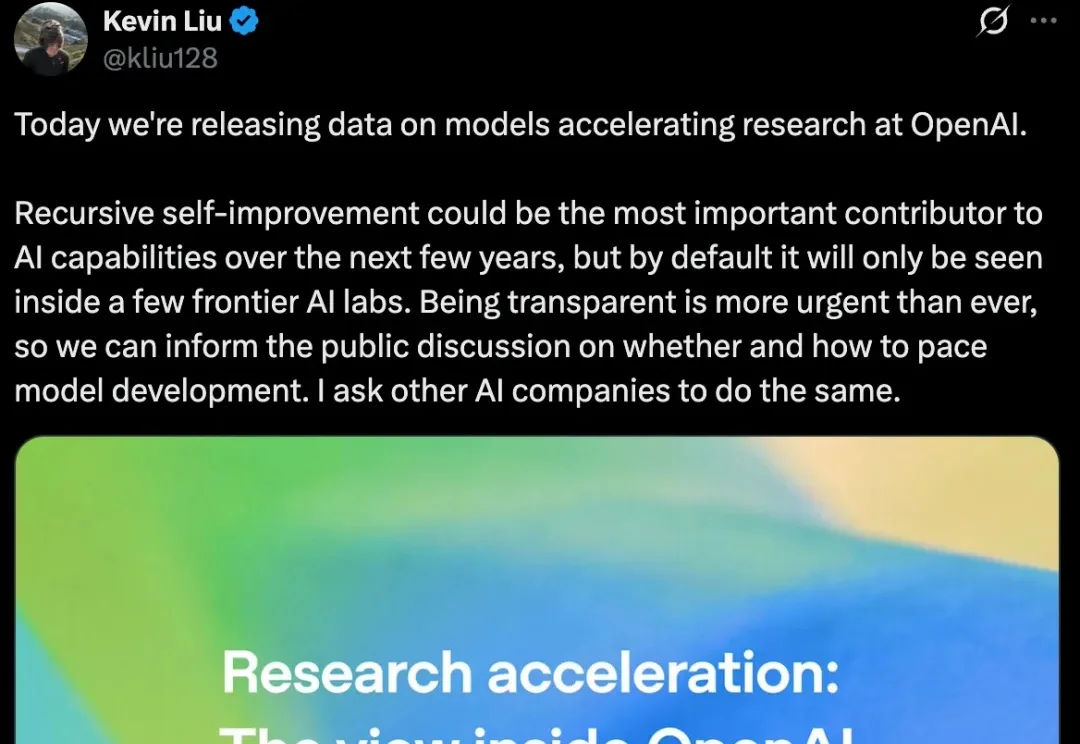
前些天,号称「实现 AGI」的 GPT-6 Astra 发布后,引发了全网对于递归自我改进架构的热议。
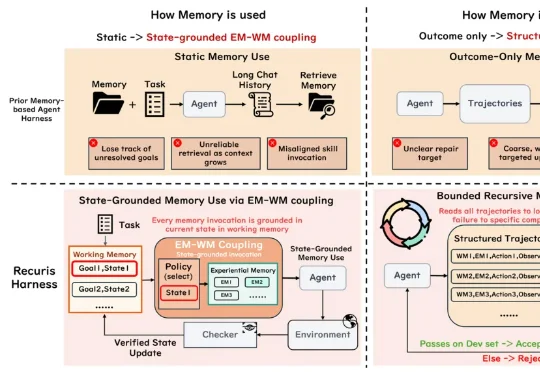
在此背景下,新加坡国立大学、普林斯顿大学与斯坦福、牛津等研究团队合作提出了 Recuris(Recursive Experiential–Working Memory Evolution),作为首个将递归自我改进应用在记忆控制层内的智能体架构,Recuris 通过三项核心技术突破,无需训练即成功实现了从 3B 小模型到 Claude Opus 5 的全面提升。