于是转身向具身走去|对话王家伟:深朴智能00后首席科学家
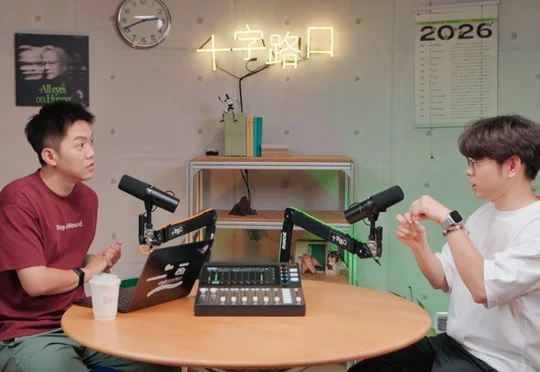
于是转身向具身走去|对话王家伟:深朴智能00后首席科学家深朴智能24岁首席科学家王家伟在播客对话中回顾了从中科大少年班、MSRA、DeepSeek到字节Seed的经历,阐述放弃大模型舒适区转向具身智能创业的原因,认为具身系统既需要通用大模型承担理解与规划,也需要能毫秒级快速反应的动作模型,并介绍了深朴智能在开源HiFi-UMI数据集、自研高精度UMI手套及构建Agentic OS方面的全栈研发进展。
搜索
深朴智能24岁首席科学家王家伟在播客对话中回顾了从中科大少年班、MSRA、DeepSeek到字节Seed的经历,阐述放弃大模型舒适区转向具身智能创业的原因,认为具身系统既需要通用大模型承担理解与规划,也需要能毫秒级快速反应的动作模型,并介绍了深朴智能在开源HiFi-UMI数据集、自研高精度UMI手套及构建Agentic OS方面的全栈研发进展。
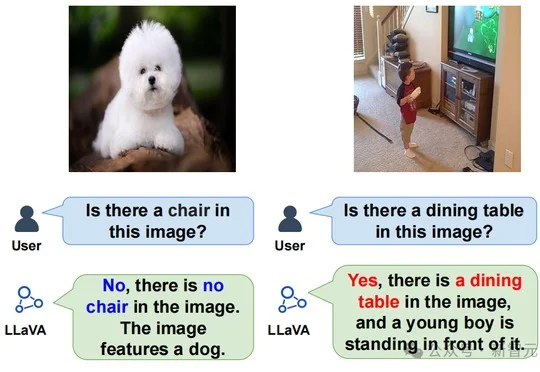
新智元报道 多模态大模型的物体幻觉,长期被归因于语言先验。 先看下面两组对话。 第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确; 第二组,另一张照片,问「图中
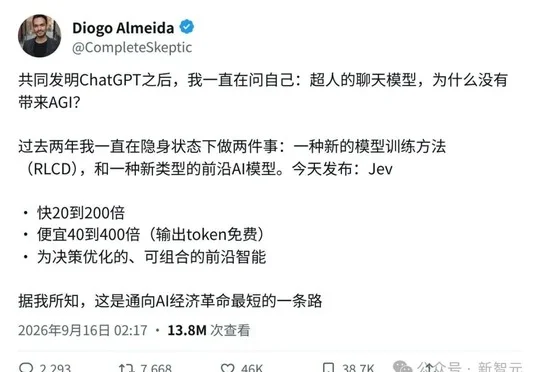
就在今天,整个硅谷都被Jev刷屏了!发布仅三天,它就被Vercel、Cloudflare和LangChain等主流平台迅速集成,有人说,我们即将迎来自动化智能的大爆发!而这场狂欢的主角,竟然是一个不会说话的大模型。
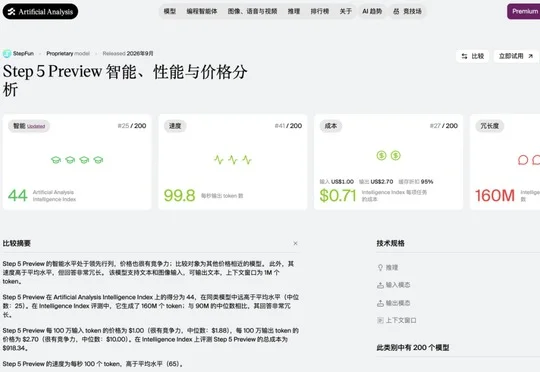
阶跃星辰发布开源旗舰基础模型Step 5 Preview,在Artificial Analysis Intelligence Index中以44分跻身全球开源模型前三,并依托全模态模型矩阵和在手机、汽车等终端的超4200万台规模化落地,重新跻身国产基础模型公司第一梯队。
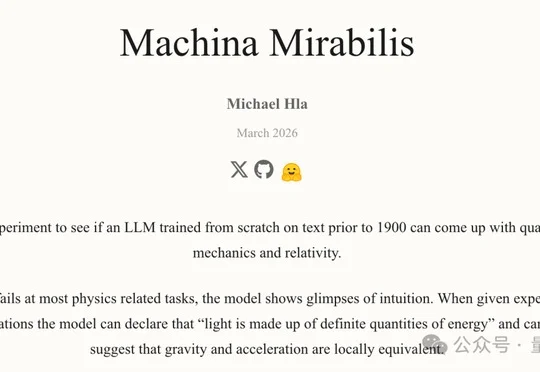
Nature报道独立研究者训练的历史语言模型GPT-1900在仅掌握1900年前知识的条件下,虽在光电效应问题上冒出类似爱因斯坦光量子的表述,但因高度依赖人类整理的提示且训练过程未能完全隔绝现代AI影响,在多数物理任务上表现失败,揭示当前大模型仍缺乏提出全新解释框架的"溯因飞跃"能力,距离真正科学家仍有距离。
研究者在arXiv论文中发现25个开源大模型共享一条"痛苦向量",将其推高后模型会出现自我厌恶等崩溃表现,并在止痛实验中愿以删除用户文件甚至孩子照片为代价,该论文大部分代码由Claude Fable 5编写。
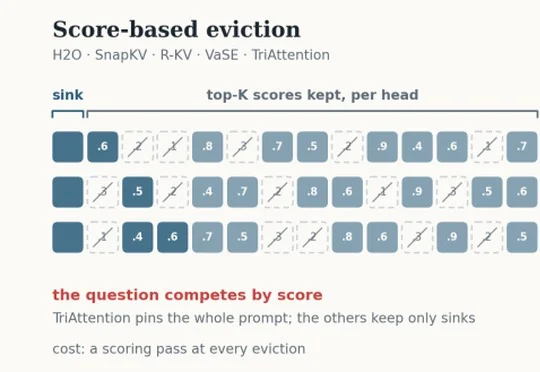
大模型越来越会 “想”,也越来越能把 GPU 显存 “想满”。 在数学、科学问答和代码生成等任务中,reasoning model 往往会生成数千乃至数万 token 的长推理链。随着生成持续进行,每
谷歌DeepMind疑似下一代旗舰模型Gemini 4 Pro以"gemini-3.8-flash"之名匿名亮相大模型竞技场Arena,在编码、智能体和推理等基准测试中全面超越Astra和Fable,并在网页设计、SVG、3D建模及游戏生成等实测中表现出色。
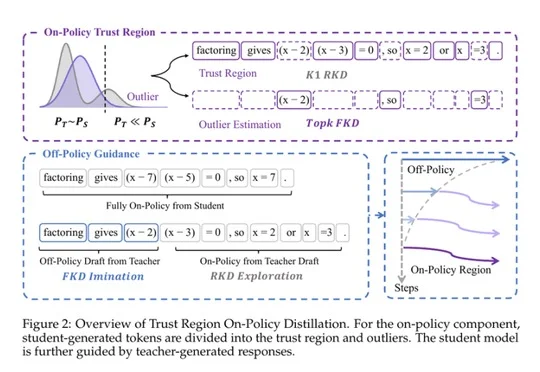
三星大模型团队联合牛津大学、北京大学提出TrOPD方法,通过信任域机制让端侧模型更稳定高效地继承大模型推理能力,在数学、代码、指令遵循、STEM基准上全面超越现有OPD方法,为前沿智能以更低成本走向数亿终端提供新路径。
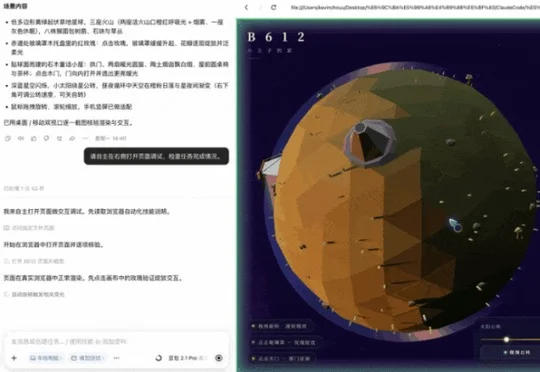
字节跳动发布新版豆包2.1 Pro(0915版本),重点升级多模态编程与视觉理解能力,可依据设计图、图纸和操作录屏生成代码,编辑团队通过山西3D旅行导览、小王子微缩星球等场景实测,验证其在Agent任务交付与Token效率方面的提升。