喝点VC|红杉资本合伙人Sonya Huang:企业开始掌握自己命运,AI应用层开始反攻模型
喝点VC|红杉资本合伙人Sonya Huang:企业开始掌握自己命运,AI应用层开始反攻模型红杉资本合伙人Sonya Huang指出,随着开放权重模型逼近前沿水平、后训练基础设施逐渐成熟,越来越多AI应用公司开始通过纵向整合构建自有AI能力、掌握模型权重,以降低成本并掌控产品命运。
来自主题: AI资讯
8675 点击 2026-09-07 16:45

 搜索
红杉资本合伙人Sonya Huang指出,随着开放权重模型逼近前沿水平、后训练基础设施逐渐成熟,越来越多AI应用公司开始通过纵向整合构建自有AI能力、掌握模型权重,以降低成本并掌控产品命运。
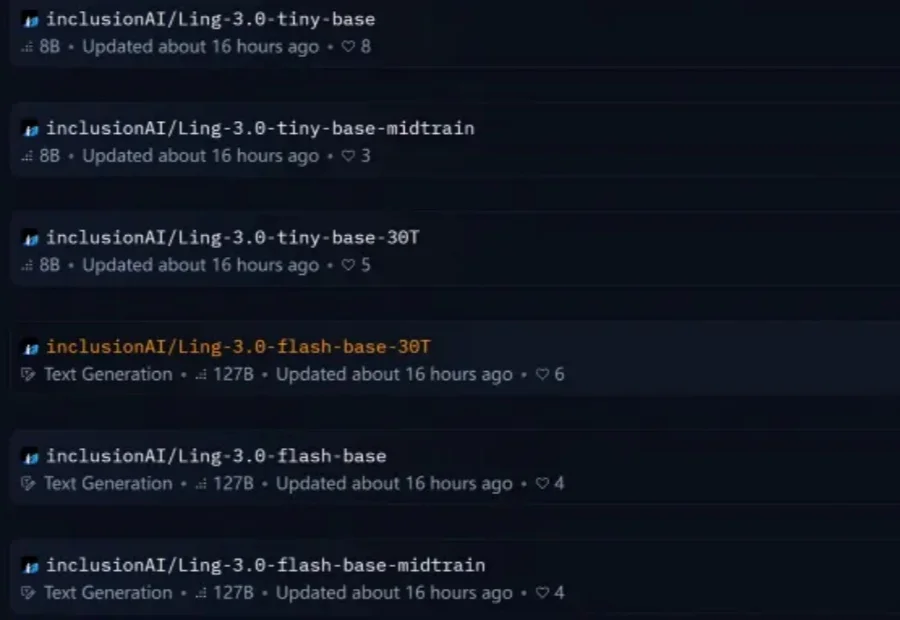
百灵为开发者提供了多个可继续训练的起点。今日,蚂蚁百灵开源Ling-3.0-tiny-base和Ling-3.0-flash-base。除最终Base模型权重外,团队还同步开放了两款模型的预训练和中期训练权重,共计6个checkpoints。

刚刚,阿里千问正式开源Qwen3.8-27B模型权重。Qwen3.8-27B是一款270亿参数的原生多模态稠密模型,支持图像、视频理解,原生上下文长度达到262K,并可通过YaRN扩展至100万Tokens。

刚刚,阿里千问大模型团队开放Qwen3.8-2.4T-A95B模型权重! Qwen3.8-Max是基于Qwen3.8-2.4T-A95B的官方版本,于8月3日发布,拥有更多功能,例如视觉输入功能、无需思考即可使用、默认支持1百万上下文长度处理、内置官方工具等。
最近,月之暗面 kimi 正式开源 Kimi K3 完整模型权重,Kimi K3 是一款总参数量达 2.8 万亿、上下文窗口达 100 万 token 的 MoE 大模型,更是全球首个落地的近 3 万亿参数级开源大模型,引起业界热议。
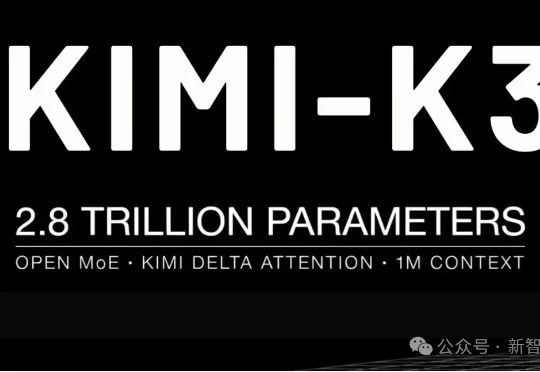
就在刚刚,全球首个3万亿参数级开源模型Kimi K3正式开源!https://github.com/MoonshotAI/Kimi-K3/tree/main。Moonshot AI宣布,发布Kimi K3的模型权重、技术报告,并开源支撑Kimi K3模型训练的关键Infra技术:MoonEP、FlashKDA和AgentEnv。
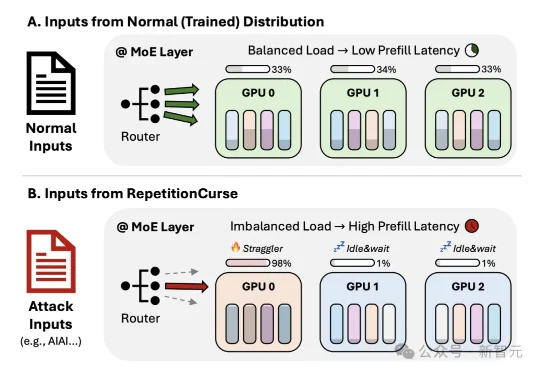
来自港科大的研究团队提出了RepetitionCurse,这是一种针对MoE大模型服务的黑盒压力测试方法。它不需要模型权重,不需要梯度,也不需要知道后端专家如何部署,只利用高度重复的输入模式,就能诱导专家路由把大量token路由到同一小批专家上。
我们在上周五开源了 MiniMax M3 模型权重,同步发布了 MSA(MiniMax Sparse Attention)技术论文。MSA 的架构设计让 M3 在长上下文下的计算成本大幅降低,论文中完整披露了架构与工程实现细节。
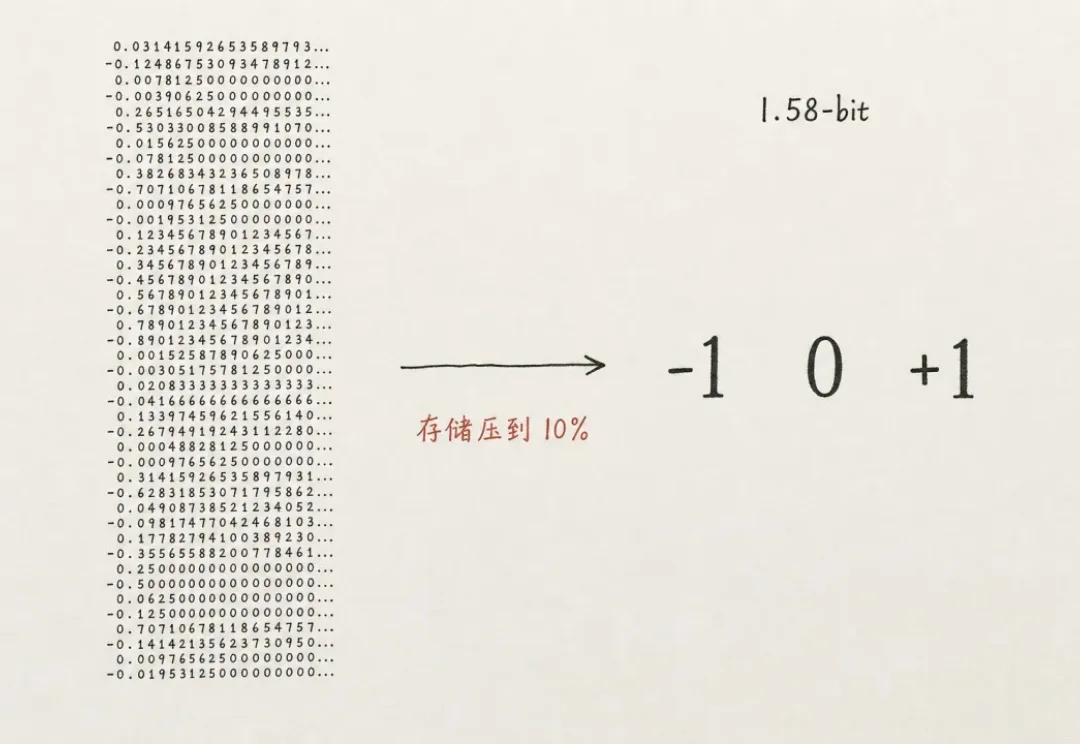
刚刚的,面壁智能联合 OpenBMB 搞了个端侧开源周。今天作为开源周的第一天,端出来的是个好东西 BitCPM-CANN,模型权重只需要约 200 MB 的内存,手表也够跑
一次低级失误,让全球开发者拿到了 AI 编程工具的「行业标准答案」。一个更重要的问题是,AI 公司,应该如何利用这次「泄露」,抄作业?很多人第一反应是:Claude Code 不就是一个套了模型 API 的命令行工具吗?源代码泄露了又怎样,没有模型权重,这些代码不过是个「壳子」。