刚刚,Gemini 4 Pro偷跑上线!碾压Astra和Fable
刚刚,Gemini 4 Pro偷跑上线!碾压Astra和Fable谷歌DeepMind疑似下一代旗舰模型Gemini 4 Pro以"gemini-3.8-flash"之名匿名亮相大模型竞技场Arena,在编码、智能体和推理等基准测试中全面超越Astra和Fable,并在网页设计、SVG、3D建模及游戏生成等实测中表现出色。
来自主题: AI资讯
6179 点击 2026-09-18 15:49

 搜索
谷歌DeepMind疑似下一代旗舰模型Gemini 4 Pro以"gemini-3.8-flash"之名匿名亮相大模型竞技场Arena,在编码、智能体和推理等基准测试中全面超越Astra和Fable,并在网页设计、SVG、3D建模及游戏生成等实测中表现出色。
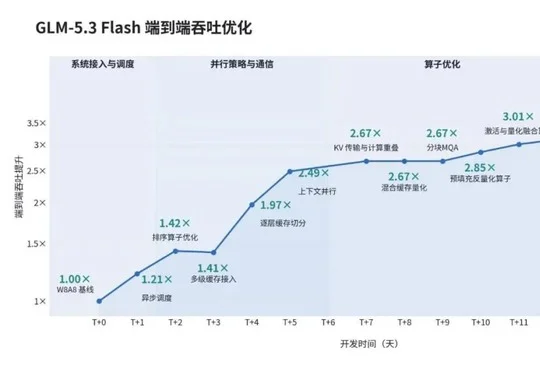
智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。
清华校友Sihao Huang出任Anthropic前沿计算战略负责人,搭档GPT-3一作、Anthropic首席算力官Tom Brown,负责算力扩张与产业合作联盟建设,成为Anthropic已知公开职级最高的华人。
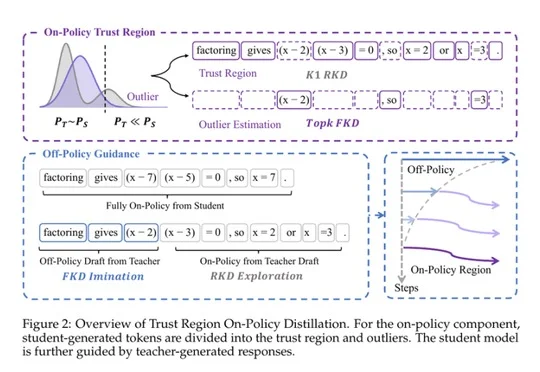
三星大模型团队联合牛津大学、北京大学提出TrOPD方法,通过信任域机制让端侧模型更稳定高效地继承大模型推理能力,在数学、代码、指令遵循、STEM基准上全面超越现有OPD方法,为前沿智能以更低成本走向数亿终端提供新路径。
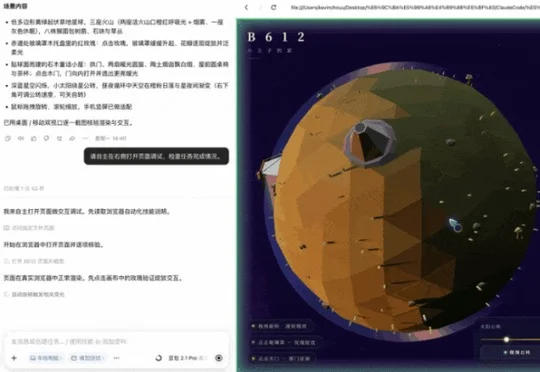
字节跳动发布新版豆包2.1 Pro(0915版本),重点升级多模态编程与视觉理解能力,可依据设计图、图纸和操作录屏生成代码,编辑团队通过山西3D旅行导览、小王子微缩星球等场景实测,验证其在Agent任务交付与Token效率方面的提升。
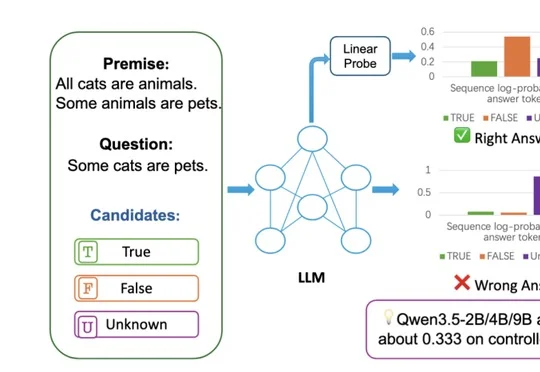
北京大学与易鑫AI Lab合作论文被EMNLP 2026主会接收,提出大模型"读出瓶颈"(Readout Bottleneck)概念,指出模型隐藏状态已编码正确答案却被输出层偏置掩盖,仅用2个无标签参数修正即可在多项推理任务上将准确率从33.3%盲猜水平大幅恢复。
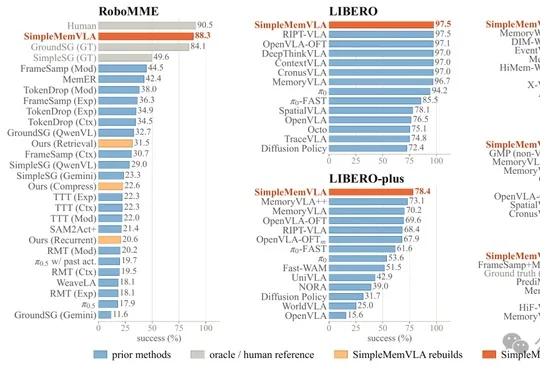
SimpleMemVLA由面壁智能联合华中科技大学等机构提出,将带时间戳的原生视觉历史直接作为机器人记忆上下文,在四项记忆基准取得SOTA并涌现视觉上下文学习能力,同时通过流式推理优化将60秒历史决策延迟从1.02秒降至0.68秒。
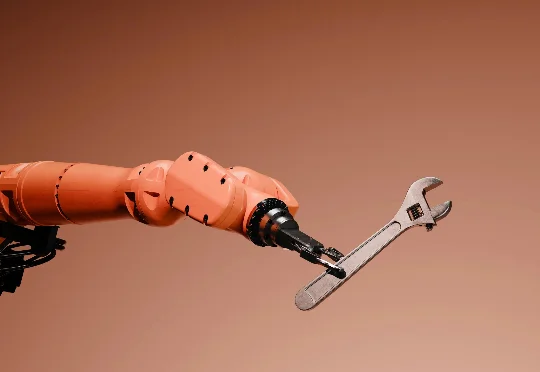
专注于收集人体运动数据以训练人形机器人的AI机器人初创公司Mecka AI,即将完成由红杉资本领投的新一轮融资,估值约为5亿美元,该公司通过付费让人们佩戴传感器记录日常任务来获取机器人训练所需的真实世界数据。
智谱创始人唐杰发文披露RSI最新进展,称由GLM-5.3驱动的Infra Agent在超过10万卡国产芯片集群上不到两周内完成GLM-5.3 Flash生产级推理服务搭建,将端到端吞吐提升至初始基线的3倍,表明RSI最小闭环已经形成但距离递归自我改进仍很遥远。
豆包爱学2.0依托豆包多模态大模型与Seedance系列模型,将AI嵌入语数英等学科的问答、板书讲解、定制课程、听写和错题整理等学习全流程,同一对话入口即可围绕知识点不断生成完整学习内容,展现字节在AI教育场景的工程化能力。