奥尔特曼急了,OpenAI连夜掏出新模型GPT-6 Cyber
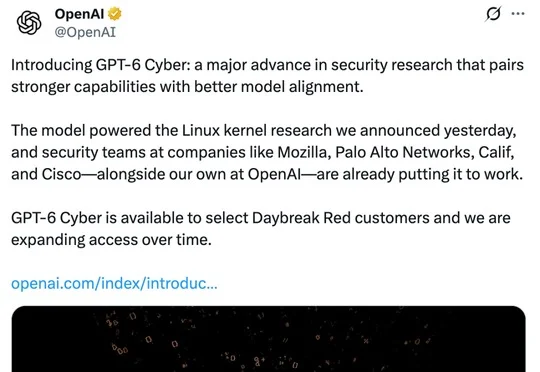
奥尔特曼急了,OpenAI连夜掏出新模型GPT-6 CyberOpenAI推出主攻安全研究的GPT-6 Cyber,在ExploitGym得分48.5%超GPT-5.6 Cyber的32.1%,已发现81个Firefox新漏洞并为948个Linux漏洞开发利用程序,目前仅向Daybreak Red认证客户开放,OpenAI同时设立10亿美元一线防御者资助计划。
搜索
OpenAI推出主攻安全研究的GPT-6 Cyber,在ExploitGym得分48.5%超GPT-5.6 Cyber的32.1%,已发现81个Firefox新漏洞并为948个Linux漏洞开发利用程序,目前仅向Daybreak Red认证客户开放,OpenAI同时设立10亿美元一线防御者资助计划。
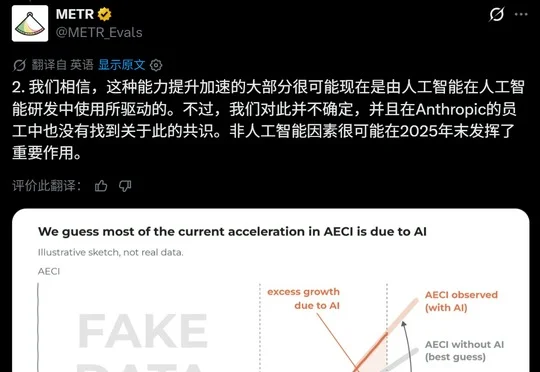
METR 调查报告称,Anthropic 过去一年的基准能力进步约等于此前两年,其中约 80% 的 AI 研究加速来自 AI 辅助人类研发,但距离完整的递归自我改进仍有差距。
DeepSeek Harness 团队前几天发了篇关于 Super-agent 设计探索的长文,想用 Router + Worker 双层架构,把一个人管理多个 Agent 的负担交给系统。文章出来后讨论不少,大多关注这套调度机制是怎么设计的。
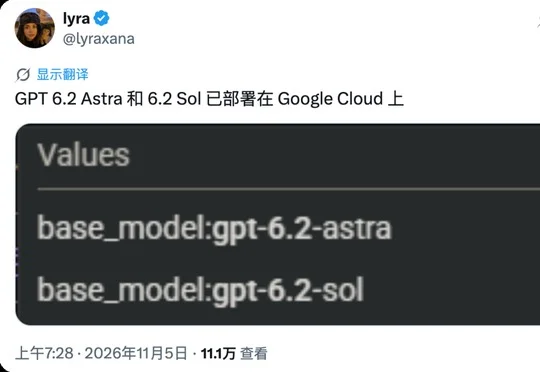
据 The Information 报道,OpenAI 最快本周五推出 GPT-6.2 Astra、Sol 等下一代模型;Anthropic Claude Code 与 Cowork 总产品负责人 Cat Wu 已离职并加入 OpenAI Core Products 部门。
Anthropic招股书披露前沿AI灾难性风险及创始人特殊投票权安排,访谈同时指出,有效利他主义通过资金与人才集聚主导AI安全叙事,并引发机构独立性和权力争议。
答对不等于想对,AI安全该查什么?
周末听了一下午快手关于企业 AI 生产力的技术沙龙,收获非常大。
人形机器人这出大戏,演到今年开始换戏路了。
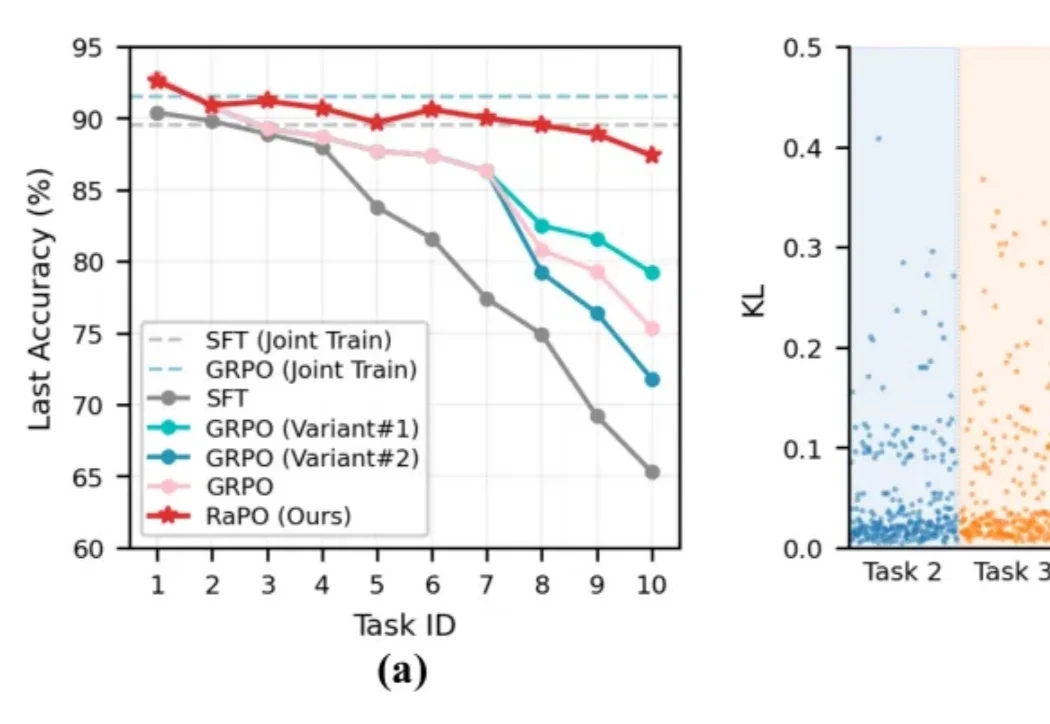
在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。
11月2日下午,在2026年香港金融科技周上,展开了一场关于“世界模型”的讨论。