LeCun出手,造出视频世界模型,挑战英伟达COSMOS
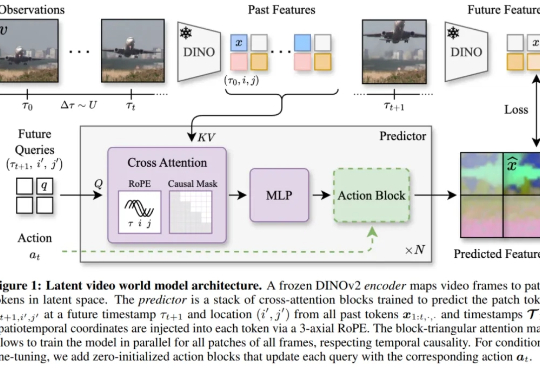
LeCun出手,造出视频世界模型,挑战英伟达COSMOS2018 年,LSTM 之父 Jürgen Schmidhuber 在论文中( Recurrent world models facilitate policy evolution )推广了世界模型(world model)的概念,这是一种神经网络,它能够根据智能体过去的观察与动作,预测环境的未来状态。
搜索
2018 年,LSTM 之父 Jürgen Schmidhuber 在论文中( Recurrent world models facilitate policy evolution )推广了世界模型(world model)的概念,这是一种神经网络,它能够根据智能体过去的观察与动作,预测环境的未来状态。
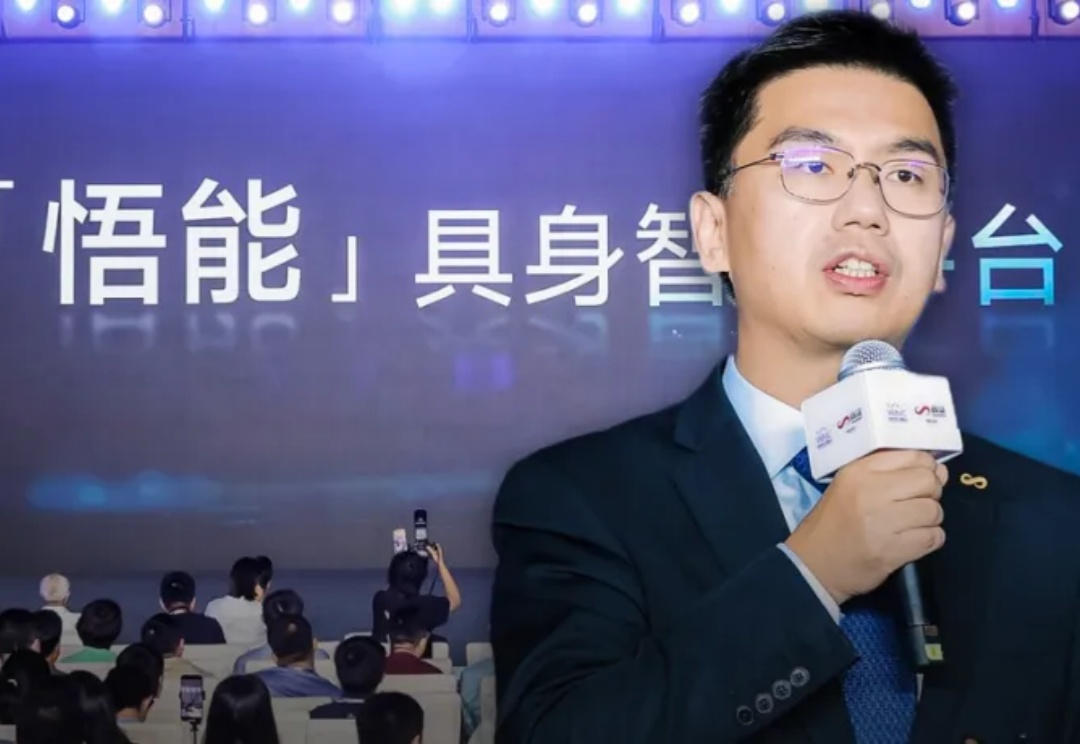
如今的具身智能,早已爆红AI圈。数据瓶颈、难以多场景泛化等难题,一直困扰着业界的玩家们。就在WAIC上,全新具身智能平台「悟能」登场了。它以世界模型为引擎,能为机器人提供强大感知、导航、多模态交互能力。
2025年7月20日,2025基础科学与人工智能论坛在中关村展示中心会议中心举行。
本文作者来自:南京大学、香港大学、中南大学、地平线、中国科学院计算所、上海交通大学、慕尼黑工业大学、清华大学。
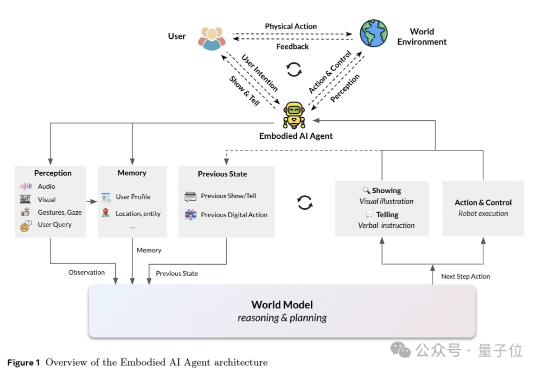
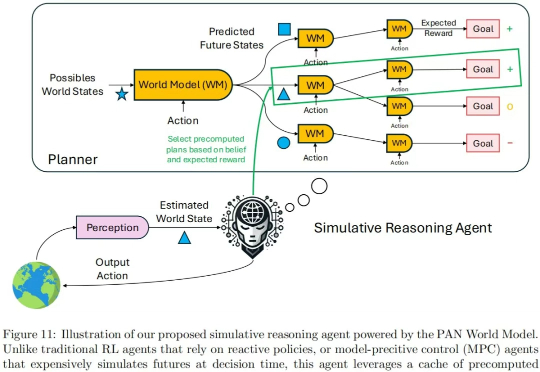
这篇报告第一次把对人心智状态的推断,放到和物理世界模型(physical world model)同等重要的位置上,并将其概念化为心智世界模型(mental world model)。相比于传统世界模型(如LeCun的JEPA)仅关注物理规律(物体运动、机械因果),心智世界模型则首次将心理规律(意图、情感、社会关系)纳入世界模型框架,实现“双轨建模”。
现在的世界模型,值得批判。 我们知道,大语言模型(LLM)是通过预测对话的下一个单词的形式产生输出的。由此产生的对话、推理甚至创作能力已经接近人类智力水平。
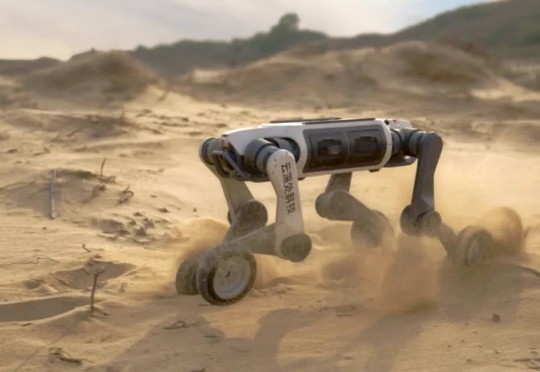
即使有一颗大隐隐于市的心,成立第八年的云深处,终究在今天具身智能的浪潮下,被推到了舞台中央。
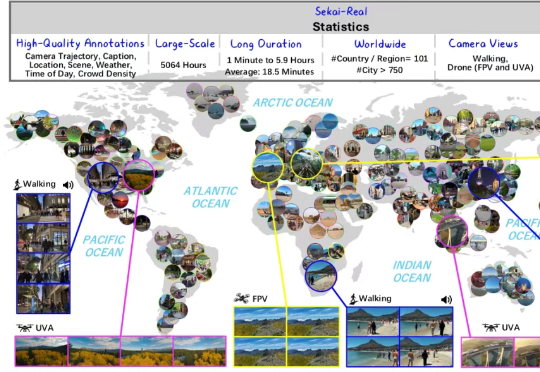
现在,国内研究机构就从数据基石的角度出发,拿出了还原真实动态世界的新进展:上海人工智能实验室、北京理工大学、上海创智学院、东京大学等机构聚焦世界生成的第一步——世界探索,联合推出一个持续迭代的高质量视频数据集项目——Sekai(日语意为“世界”),服务于交互式视频生成、视觉导航、视频理解等任务,旨在利用图像、文本或视频构建一个动态且真实的世界,可供用户不受限制进行交互探索。
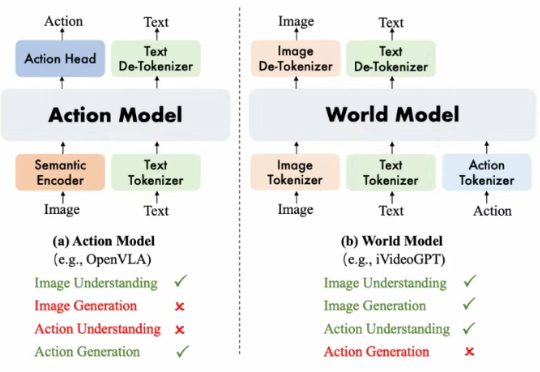
阿里巴巴达摩院提出了 WorldVLA, 首次将世界模型 (World Model) 和动作模型 (Action Model/VLA Model) 融合到了一个模型中。WorldVLA 是一个统一了文本、图片、动作理解和生成的全自回归模型。
几十年来,人工智能领域一直在思考一个看似简单但非常根本的问题: 如果一个智能体要在真实世界中行动、规划,并且和环境互动,它需要一个怎样的「世界模型」?