单个A100生成3D图像只需30秒,这是Adobe让文本、图像都动起来的新方法
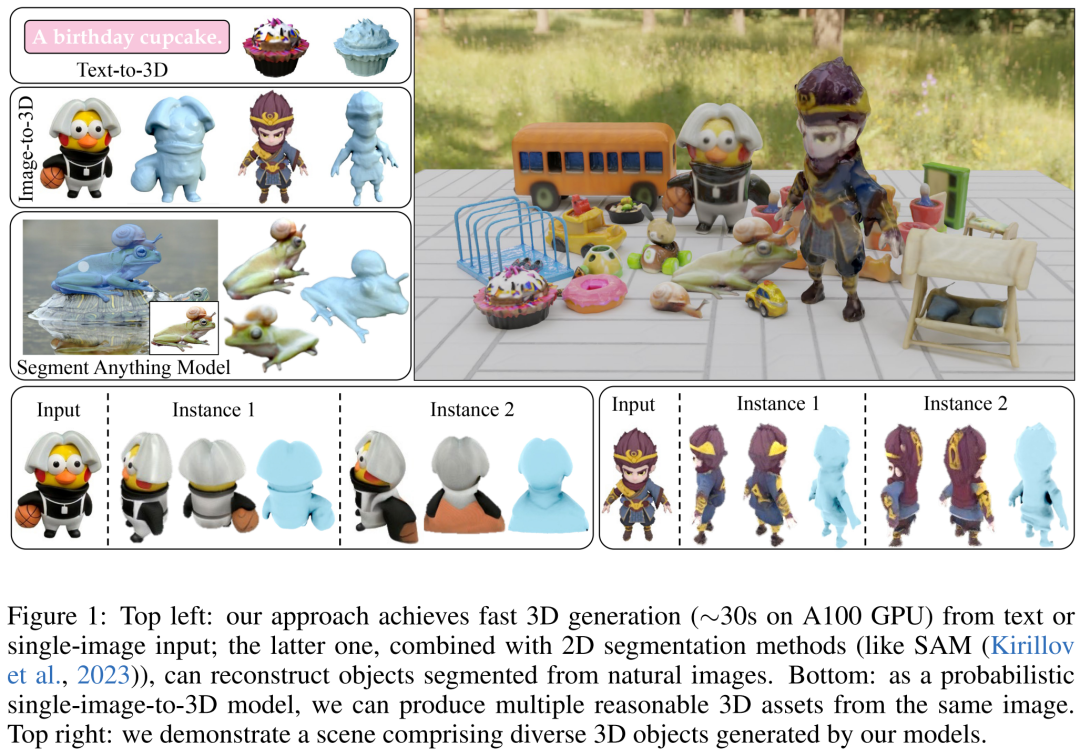
单个A100生成3D图像只需30秒,这是Adobe让文本、图像都动起来的新方法3D 生成是 AI 视觉领域的研究热点之一。本文中,来自 Adobe 研究院和斯坦福大学等机构的研究者利用基于 transformer 的 3D 大型重建模型来对多视图扩散进行去噪,并提出了一种新颖的 3D 生成方法 DMV3D,实现了新的 SOTA 结果。
搜索
3D 生成是 AI 视觉领域的研究热点之一。本文中,来自 Adobe 研究院和斯坦福大学等机构的研究者利用基于 transformer 的 3D 大型重建模型来对多视图扩散进行去噪,并提出了一种新颖的 3D 生成方法 DMV3D,实现了新的 SOTA 结果。
本文介绍了计算机科学家杰弗里·辛顿的观点,他开始担心人工智能可能对人类构成生存威胁。他认为人工智能系统可能开始自我思考,并试图取代或消灭人类文明。
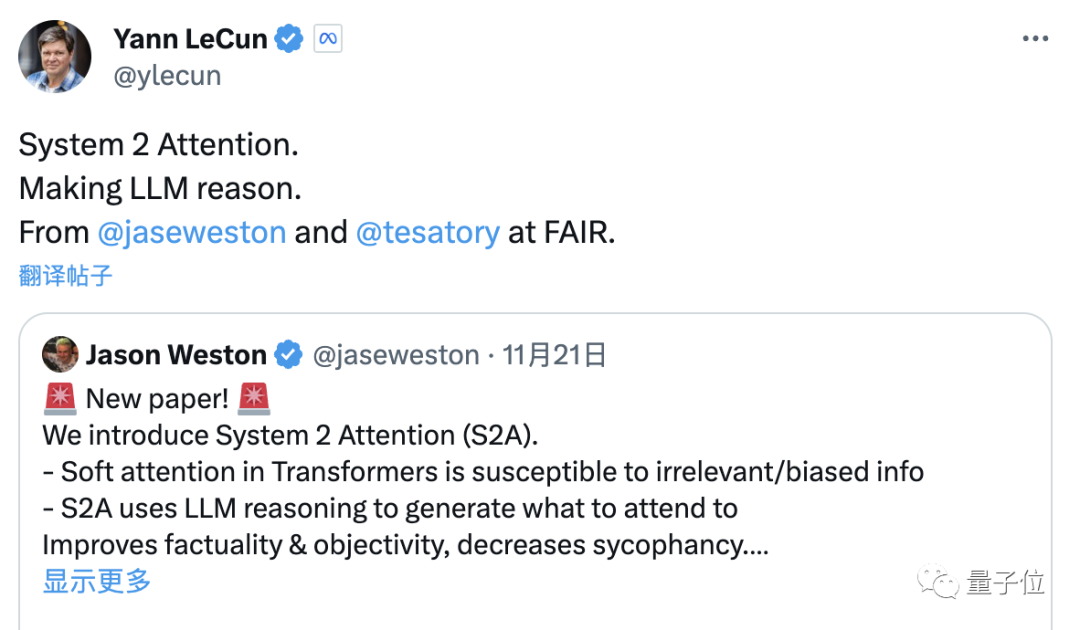
关于大模型注意力机制,Meta又有了一项新研究。通过调整模型注意力,屏蔽无关信息的干扰,新的机制让大模型准确率进一步提升。而且这种机制不需要微调或训练,只靠Prompt就能让大模型的准确率上升27%。
思维链已经out啦!想让大模型会推理还是得靠知识库:基座模型还是ChatGPT,最新思维图谱技术在多个基准数据集上实现巨大性能提升!
由南洋理工华人团队新提出的80亿参数多模态大模型OtterHD,不仅可以搞定让GPT-4V都发愁的难题,甚至还可以数出来《清明上河图》(局部)里到底有多少只骆驼!
大家都在猜测,Q*是否就是「Q-learning + A*」。 AI大牛田渊栋也详细分析了一番,「Q*=Q-learning+A*」的假设,究竟有多大可能性。 与此同时,越来越多人给出判断:合成数据,就是LLM的未来。
“AI 取代摄影”,或许真的在一步步靠近?这两日,一个名为 Magnific 的 AI 图像增强工具在外网似有冒头趋势。部分 AI 圈内的设计师第一时间得到了测试机会,并在 X 上分享了使用感受,其中不乏像 Linus Ekenstam 这样的 KOL 以及领英高级首席设计师 Armando Sotoca 这样的人物。
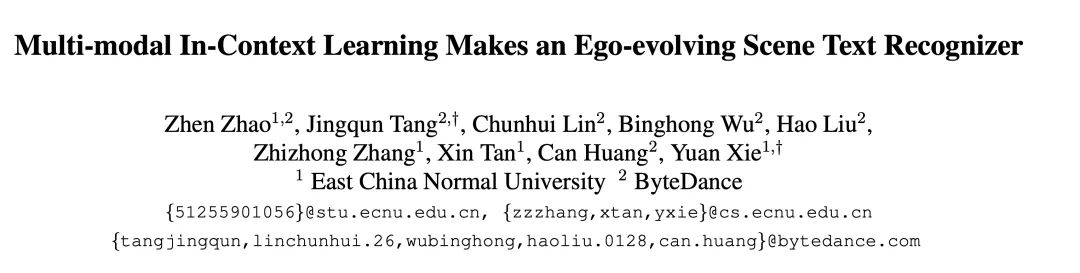
我们都知道,大语言模型(LLM)能够以一种无需模型微调的方式从少量示例中学习,这种方式被称为「上下文学习」(In-context Learning)。这种上下文学习现象目前只能在大模型上观察到。比如 GPT-4、Llama 等大模型在非常多的领域中都表现出了杰出的性能,但还是有很多场景受限于资源或者实时性要求较高,无法使用大模型。
大模型狂飙至今,已逼近一周年。撇开最近戏剧化的高层动荡不谈,自北京时间 11月 7日 OpenAI的首届开发者大会(DevDay)以“AI春晚”之势炸场以来,ChatGPT的周活跃用户超过一亿,全球用户高涨的热情直接把 OpenAI的服务器给冲宕机了,于是上面这个不受待见的画面就频繁出现在了无数人的眼前,随之而来的是人们的沮丧、愤怒甚至恐慌。
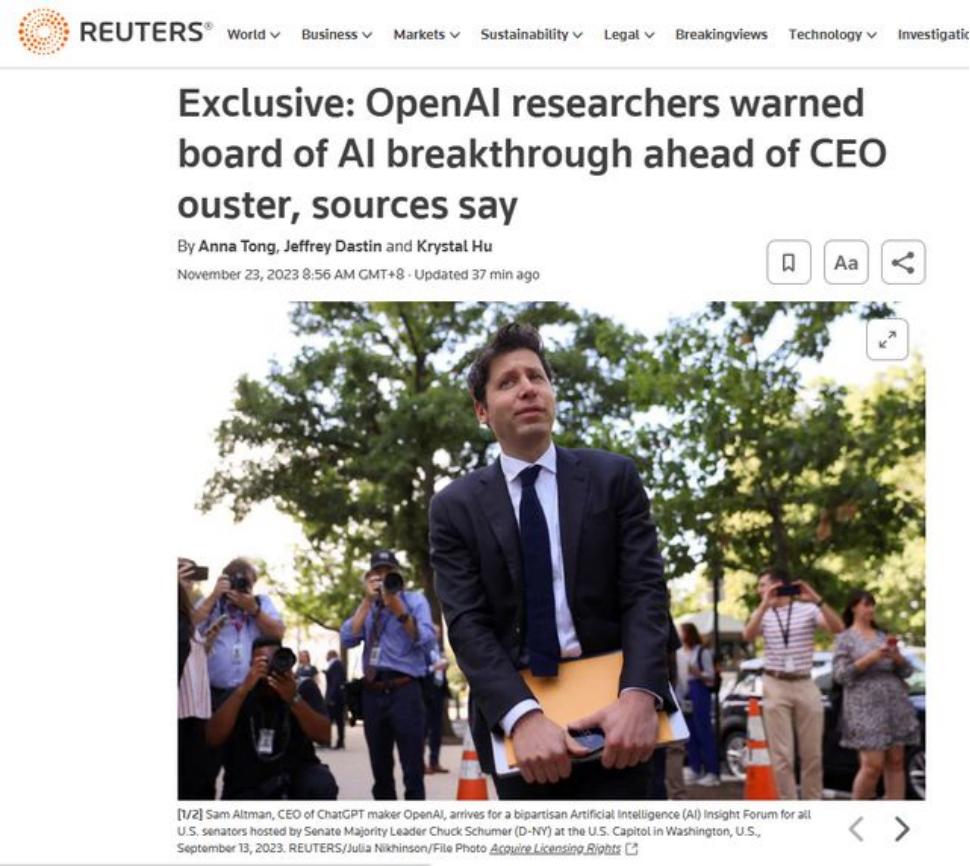
也许,解雇 Sam 是对的?前天我们发布了关于OpenAI宫斗大戏的事件经过,虽然事件以Sam重归CEO告一段落,但是董事会为何突然罢免Sam依然是一片疑团。