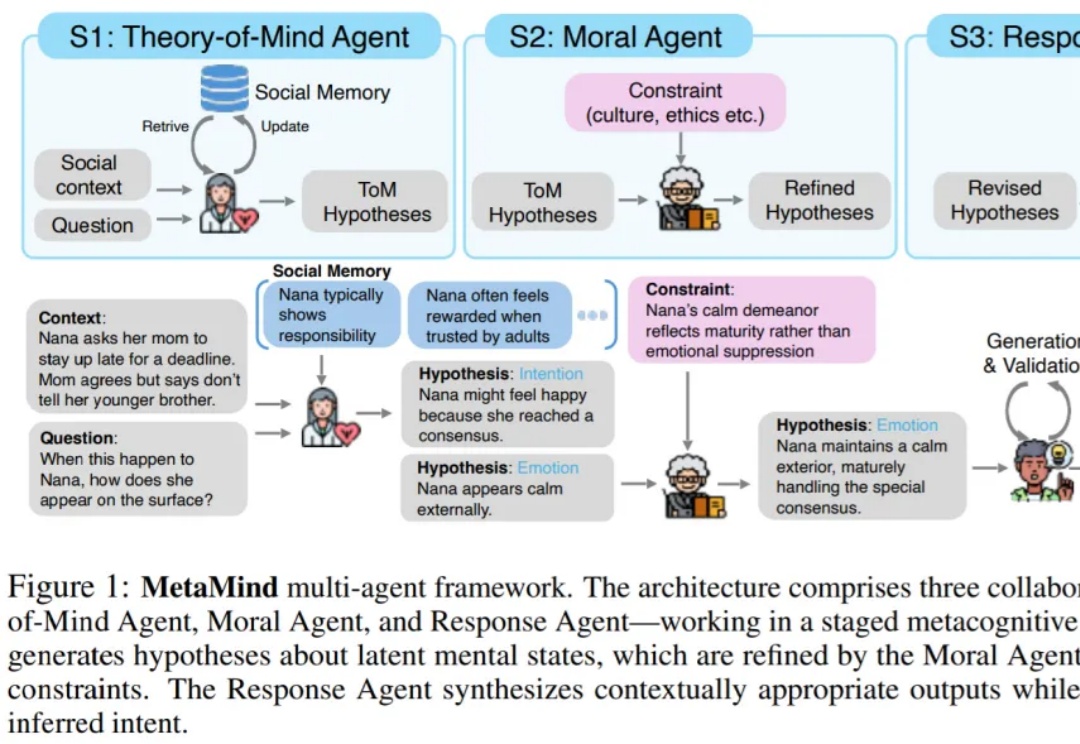
AI终于学会「读懂人心」,带飞DeepSeek R1,OpenAI o3等模型
AI终于学会「读懂人心」,带飞DeepSeek R1,OpenAI o3等模型“What is meant often goes far beyond what is said, and that is what makes conversation possible.” ——H. P. Grice
来自主题: AI技术研报
9673 点击 2025-11-21 09:16

 搜索
“What is meant often goes far beyond what is said, and that is what makes conversation possible.” ——H. P. Grice
近日,AI生命科学企业津渡生科宣布完成千万级Pre-A+轮融资,由深圳南山区战略直投平台南山战新投投资。值得注意的是,仅2025年该公司就连续获得了红杉中国种子基金、创东方投资分别领投天使+轮、Pre-A轮,加上本轮融资已完成累计近亿元人民币。
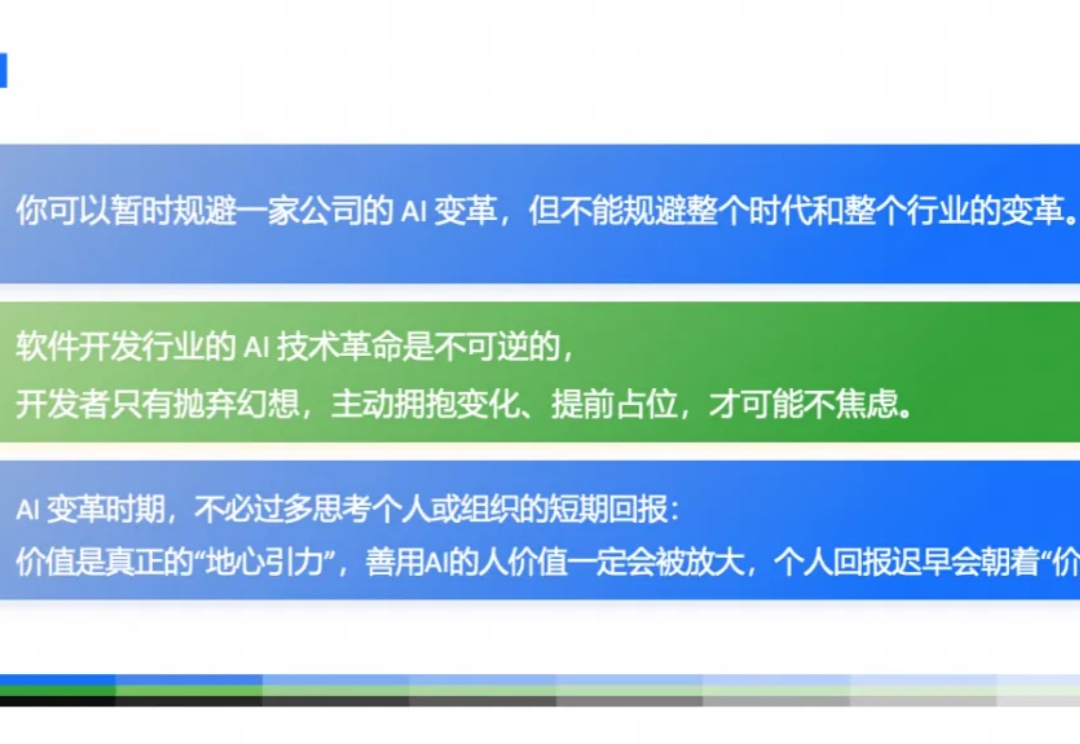
在 AI 时代,若你还在紧盯代码量、执着于全栈工程师的招聘,或者仅凭技术贡献率来评判价值,执着于业务提效的比例而忽略产研价值,你很可能已经被所谓的“常识”困住了脚步。
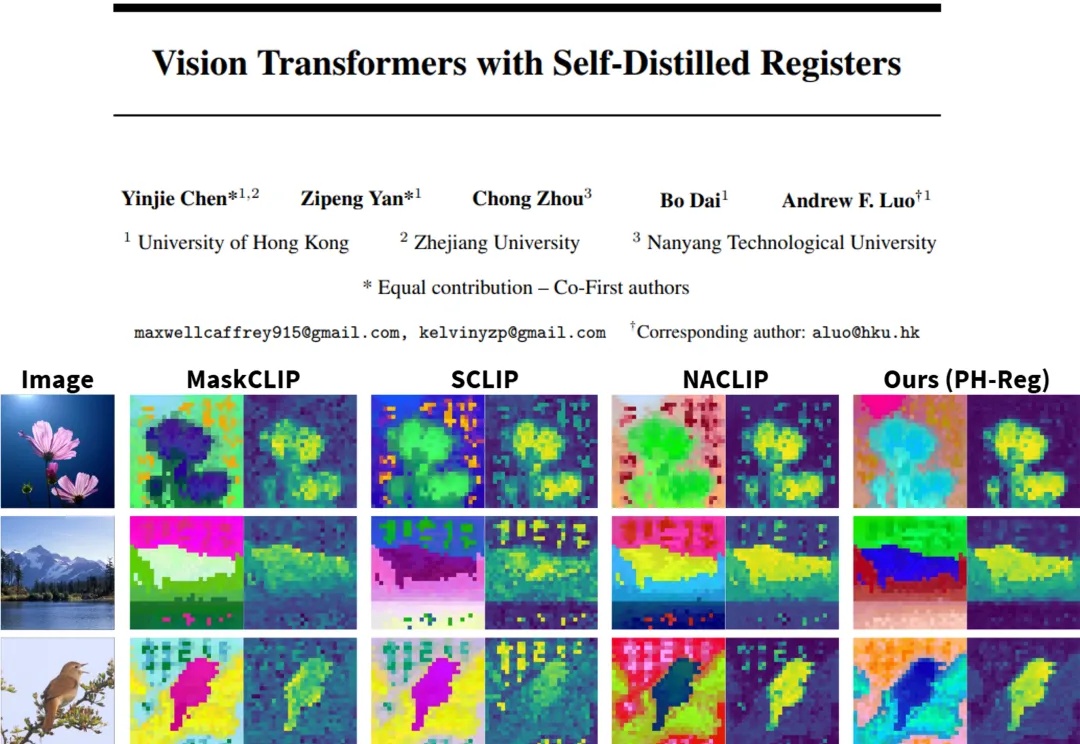
在视觉处理任务中,Vision Transformers(ViTs)已发展成为主流架构。然而,近期研究表明,ViT 模型的密集特征中会出现部分与局部语义不一致的伪影(artifact),进而削弱模型在精细定位类任务中的性能表现。因此,如何在不耗费大量计算资源的前提下,保留 ViT 模型预训练核心信息并消除密集特征中的伪影?

2024年以来,从苹果Vision Pro将「空间计算」推向巅峰,到Peloton Guide、Nex Playground等「AI摄像头」硬件开始在小规模市场中验证可行性,风口已然初现。
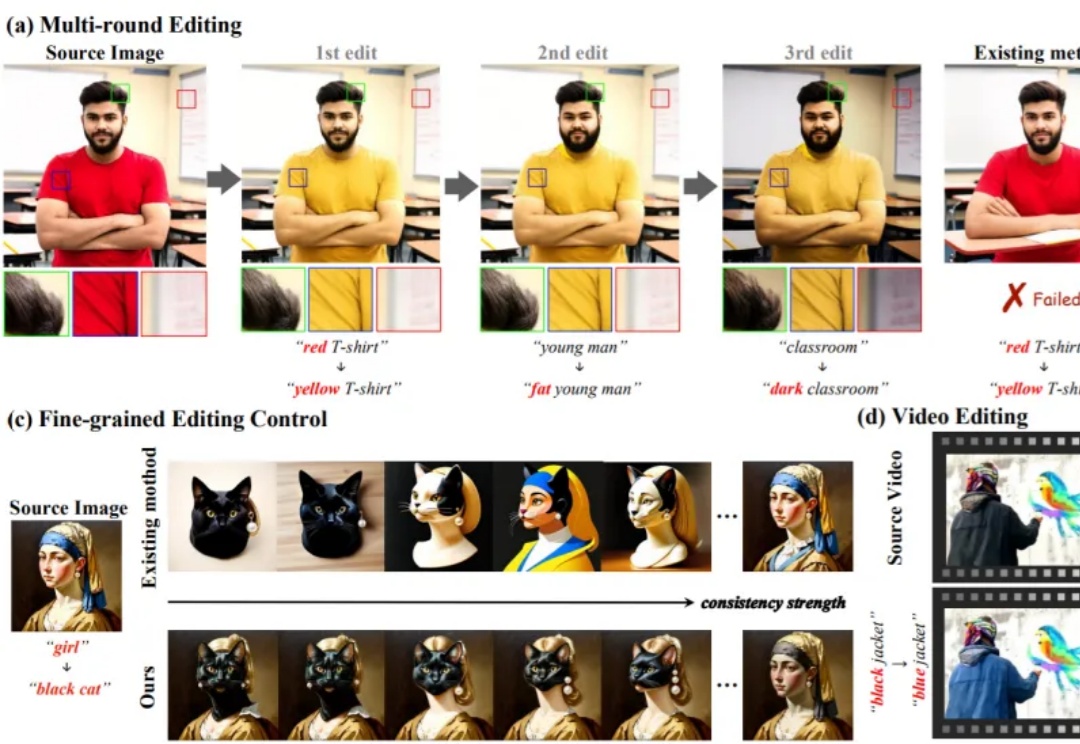
无需额外训练即可适配预训练生成模型的编辑方法,凭借灵活、高效的特性,已成为视觉生成领域的研究热点。这类方法通过操控 Attention 机制(如 Prompt-to-Prompt、MasaCtrl)实现文本引导编辑,但当前技术存在两大核心痛点,严重限制其在复杂场景的应用
2025年11月13日,创新医疗技术公司 Beacon Biosignals 宣布完成 8600 万美元(约合人民币6.1亿) B 轮融资,由 GV(Google Ventures)、Takeda、Catalio 等跨科技与生命科学领域的重磅机构联合投资,使公司累计融资突破 1.21 亿美元。
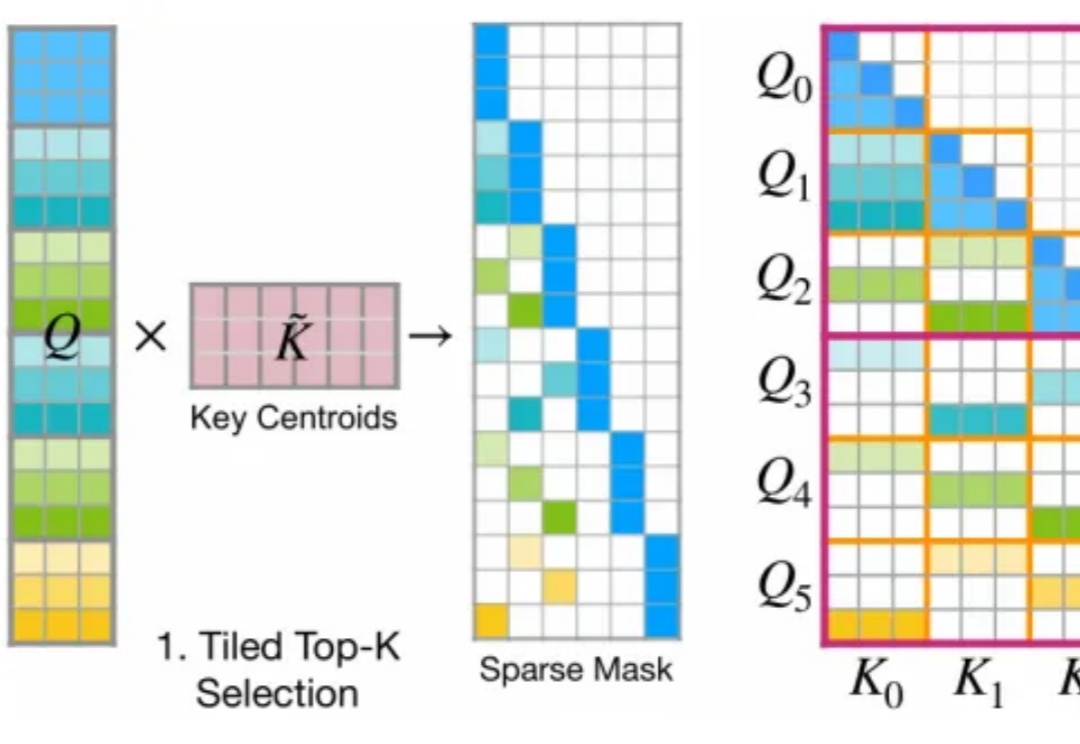
今年 2 月,月之暗面提出了一种名为 MoBA 的注意力机制,即 Mixture of Block Attention,可以直译为「块注意力混合」。
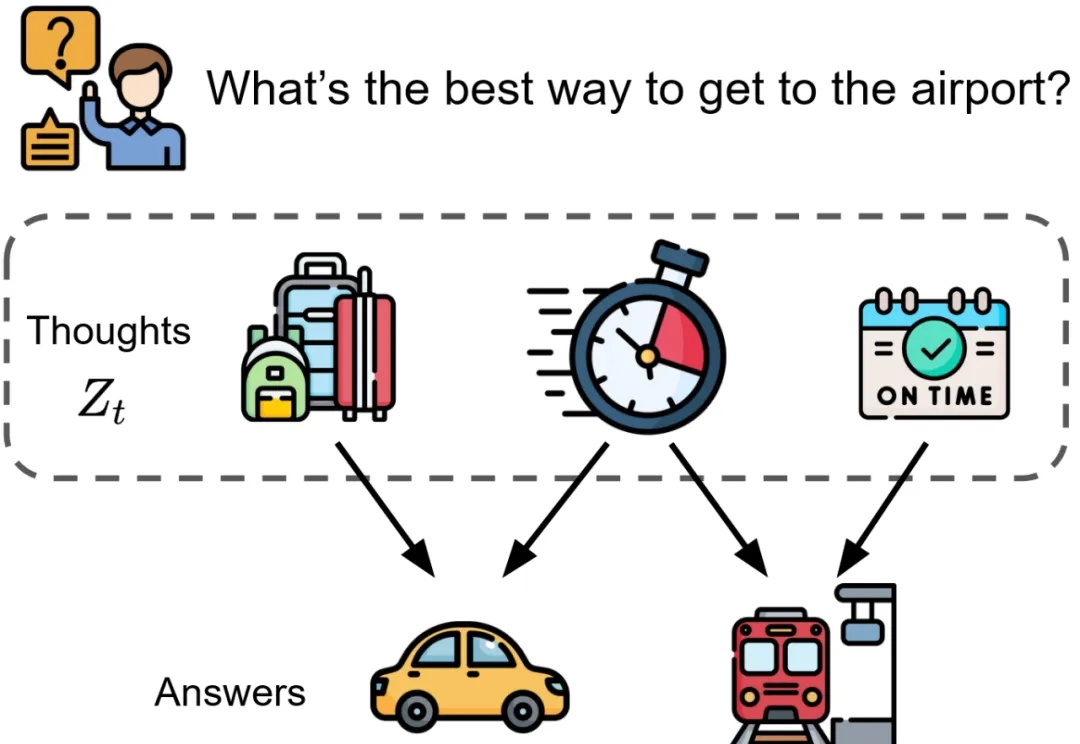
如果多个大模型能读懂彼此的想法,会发生什么?
中科大 LDS 实验室何向南、王翔团队与 Alpha Lab 张岸团队联合开源 MiniOneRec,推出生成式推荐首个完整的端到端开源框架,不仅在开源场景验证了生成式推荐 Scaling Law,还可轻量复现「OneRec」,为社区提供一站式的生成式推荐训练与研究平台。