AI资讯新闻榜单内容搜索-AR

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: AR
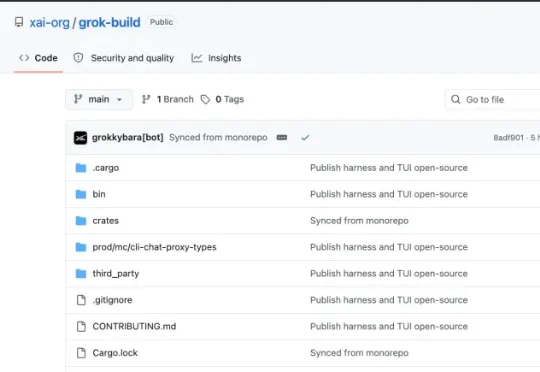
马斯克连夜开源Grok Build,但84万行代码里还留着上传用户整个代码库的痕迹

马斯克连夜开源Grok Build,但84万行代码里还留着上传用户整个代码库的痕迹

马斯克连夜开源Grok Build,但84万行代码里还留着上传用户整个代码库的痕迹

随后,SpaceXAI 兑现了承诺,在 GitHub 上正式开源了这套智能体编程框架。该公司在一篇 X 帖子中表示:“开源 Grok Build 可以让任何人都能参与构建可靠且强大的框架。”开源不到 20 个小时,Grok Build 已在 GitHub 上收获 1.21 万颗 Star。

来自主题: AI资讯
9856 点击    2026-07-17 14:59
连夜实测 Kimi K3,建议改名 Kable

连夜实测 Kimi K3,建议改名 Kable

连夜实测 Kimi K3,建议改名 Kable

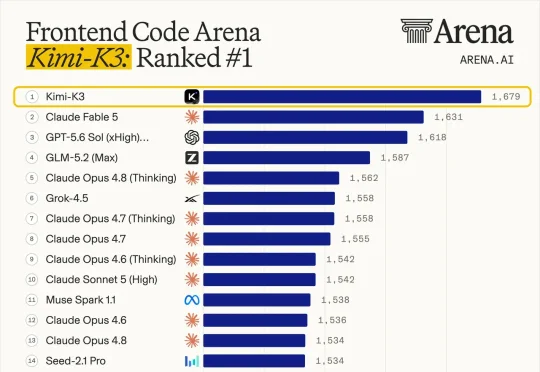
今天凌晨看到 Arena AI 更新 Code Arena 榜单时,我第一反应是有点意外。刚刚发布的 Kimi K3 拿到了 1679 分,排在全球第一,压过了 Claude Fable 5 的 1631 分和 GPT-5.6 Sol 的 1618 分。

来自主题: AI产品测评
11041 点击    2026-07-17 11:12
独家|智谱ARR达到10亿美元,半年增长15倍

独家|智谱ARR达到10亿美元,半年增长15倍

独家|智谱ARR达到10亿美元,半年增长15倍

“中国的Anthropic”走出了比Anthropic更陡峭的增长曲线。

来自主题: AI资讯
7749 点击    2026-07-17 10:43
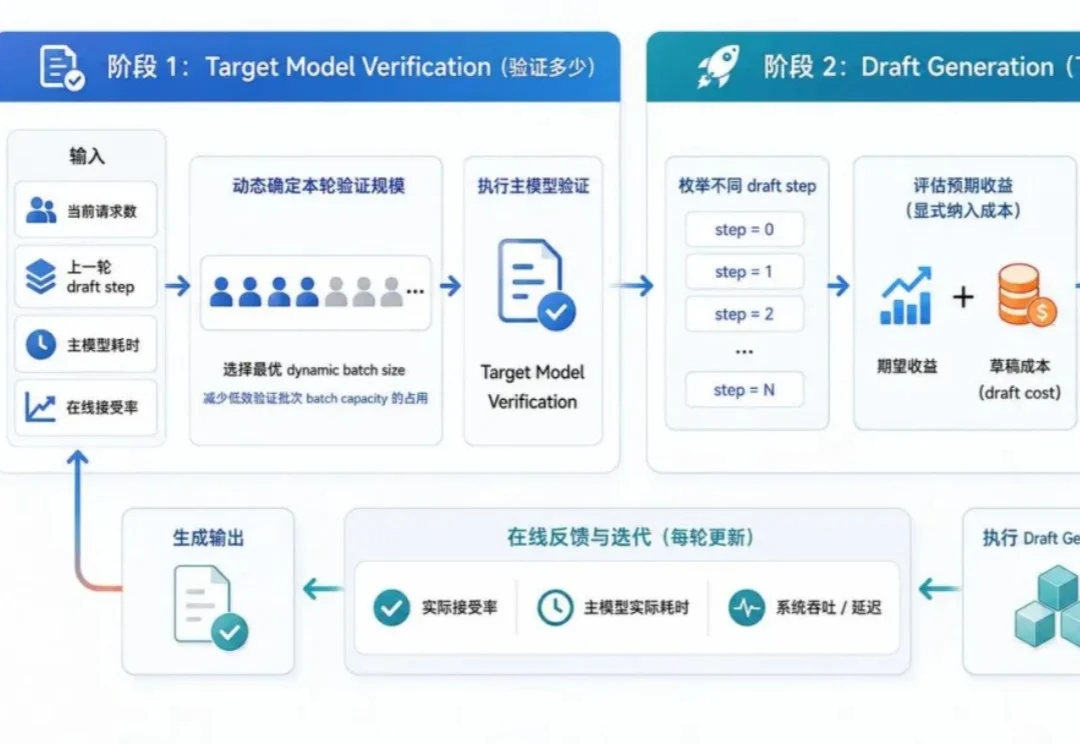
让动态投机解码不再局限于DSpark:LightSpec首个开源动态MTP系统实现

让动态投机解码不再局限于DSpark:LightSpec首个开源动态MTP系统实现

让动态投机解码不再局限于DSpark:LightSpec首个开源动态MTP系统实现

随着 DeepSeek 发布 DSpark,动态 MTP(多 Token 预测)成为了对抗高并发、提升 GPU 利用率的绝对焦点。然而,DSpark 高度绑定特定模型且需要额外训练。

来自主题: AI技术研报
9639 点击    2026-07-17 10:08
匿名模型Kivine外网刷屏,开发者们都在猜:这是Kimi-K3?

匿名模型Kivine外网刷屏,开发者们都在猜:这是Kimi-K3?

匿名模型Kivine外网刷屏,开发者们都在猜:这是Kimi-K3?

这两天,大模型竞技场Arena上出现了一个新的匿名模型,代号Kivine。经过测试和对比,再结合此前Kimi-K2.5和K2.6的匿名代号“Kiwido”和“Kiwire”,越来越多的开发者们开始猜测这个匿名模型其实就是Kimi-K3。

来自主题: AI资讯
10011 点击    2026-07-16 20:21
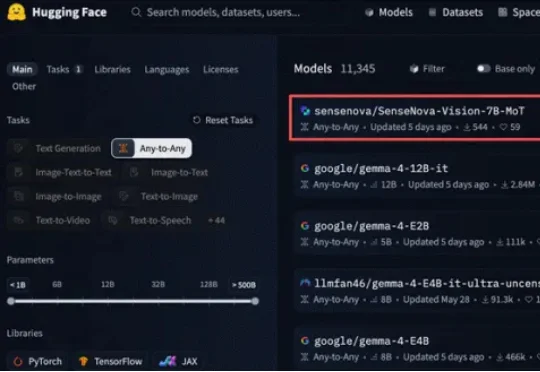
商汤科技全面开源日日新SenseNova-Vision视觉大模型

商汤科技全面开源日日新SenseNova-Vision视觉大模型

商汤科技全面开源日日新SenseNova-Vision视觉大模型

近日,商汤科技发布并全面开源日日新SenseNova-Vision理解生成统一视觉大模型,试图宣告视觉AI“缝合怪”时代的终结。截至当前,该模型综合得分登顶Hugging Face Any-to-Any Leaderboard,位列该全模态任意输入输出开源模型榜单全球第一。

来自主题: AI资讯
11121 点击    2026-07-16 18:33
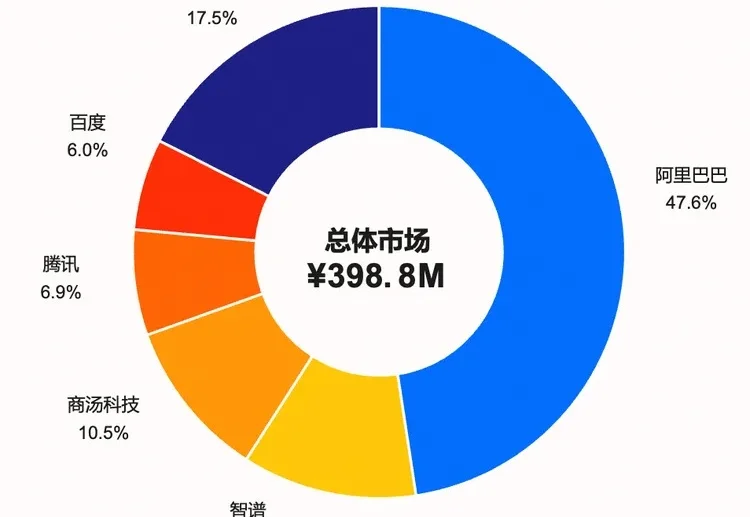
47.6%,阿里Qoder拿到了比跑分更硬的成绩

47.6%,阿里Qoder拿到了比跑分更硬的成绩

47.6%,阿里Qoder拿到了比跑分更硬的成绩

对 AI Coding 来说,有人用,比任何 Benchmark 都管用,而有人持续付费,又比有人用更管用。

来自主题: AI资讯
6229 点击    2026-07-16 14:45
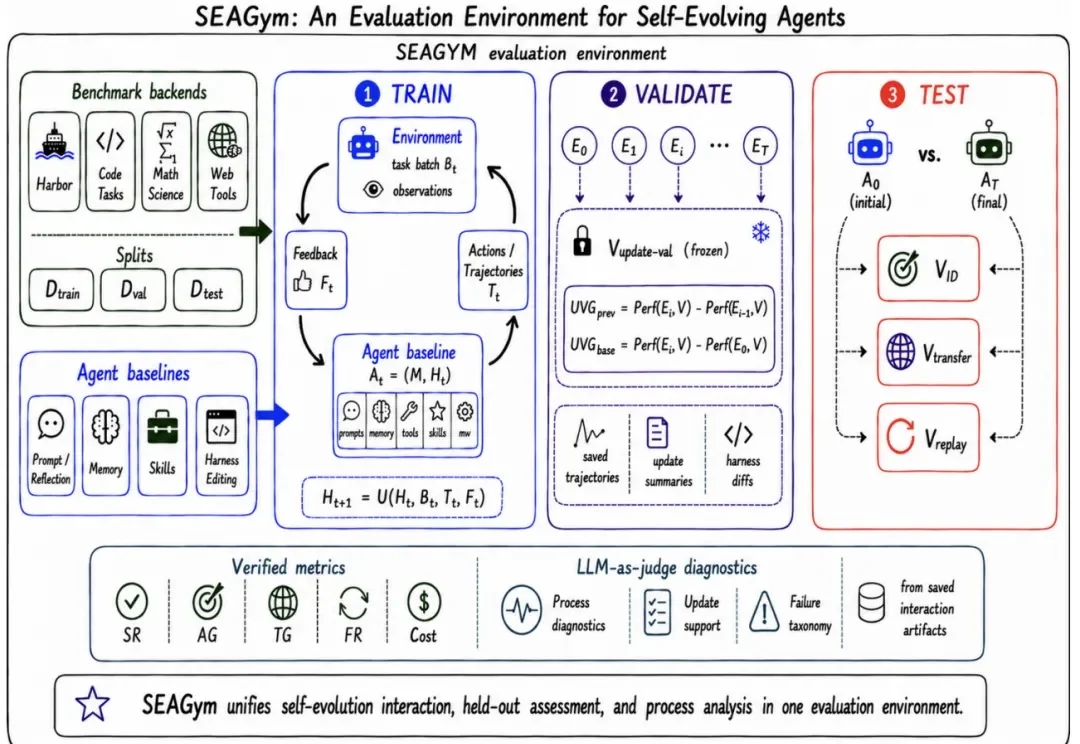
翁荔长文谈Harness自进化:Agent越用越强,评测难点怎么破?

翁荔长文谈Harness自进化:Agent越用越强,评测难点怎么破?

翁荔长文谈Harness自进化:Agent越用越强,评测难点怎么破?

近日,翁荔发布长文 《Harness Engineering for Self-Improvement》,系统梳理了 harness engineering 在 AI 自我改进中的作用。

来自主题: AI技术研报
9332 点击    2026-07-16 10:31
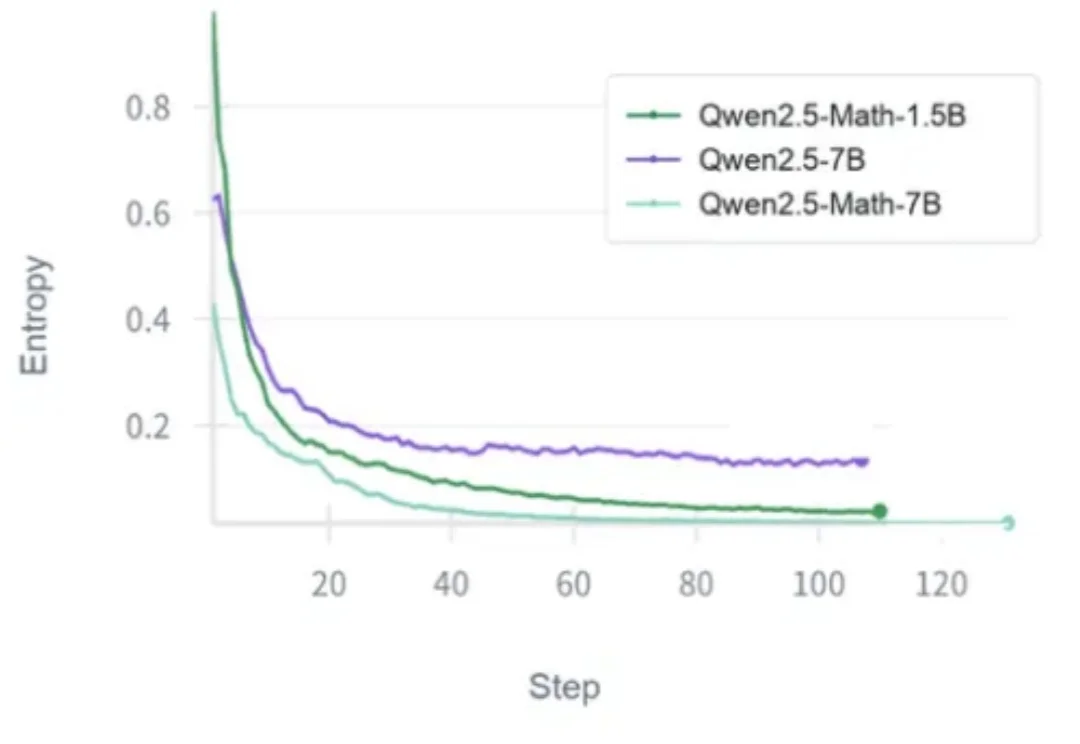
大模型RL训练为何会「越训越窄」?ACL Outstanding Paper从token-level熵变揭示RLVR训练机制

大模型RL训练为何会「越训越窄」?ACL Outstanding Paper从token-level熵变揭示RLVR训练机制

大模型RL训练为何会「越训越窄」?ACL Outstanding Paper从token-level熵变揭示RLVR训练机制

基于可验证奖励的强化学习(Reinforcement Learning with Verifiable Rewards,RLVR)正在成为大模型后训练的关键技术。数学题能判对错,代码能跑测试,可验证奖励让大模型可以通过强化学习持续提升推理能力。

来自主题: AI技术研报
10706 点击    2026-07-16 10:10
世界模型迎来「真考场」:WorldArena 2.0 Challenge正式启动

世界模型迎来「真考场」:WorldArena 2.0 Challenge正式启动

世界模型迎来「真考场」:WorldArena 2.0 Challenge正式启动

WorldArena 1.0 的核心意义,在于将世界模型评测从 “好不好看” 推进到 “是否真的有用”。它不再只关注视频观感,而是把物理一致性、可控性、3D 准确性和具身任务功能性纳入统一评测框架,使许多看似流畅的生成结果第一次在机器人具身任务中接受检验。

来自主题: AI技术研报
9813 点击    2026-07-16 10:10