
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
为 Agent 建记忆,花掉了上亿 Token,结果在相当一部分情况下,回答准确率甚至低于直接用RAG检索聊天记录。
这是 UIUC、清华、人大等机构的研究者,在《Memory Tax: Dissecting the Net Value of Agent Memory》中得到的一组结果。
他们发现,在花了上亿token,做了一连串事实提取、用户画像、分层管理、知识图谱的加工后, 11 种开源记忆系统对比最传统的RAG,在相当一部分情况下,竟然会出现负向优化。
那么问题来了:这些加工到底改善了什么,又损失了什么?又该如何避免?
研究者在 LongMemEval-s、PersonaMem-v2 和 MINT-Eval 的基准上上测试了四类记忆系统:扁平存储、分层生命周期、图结构和训练策略,并以检索原始历史的 RAG 作为对照。
下面是 LongMemEval-s 上使用 GPT-5.6 Luna 的结果。受成本限制,这组实验从完整基准中选取了 100 组语料:
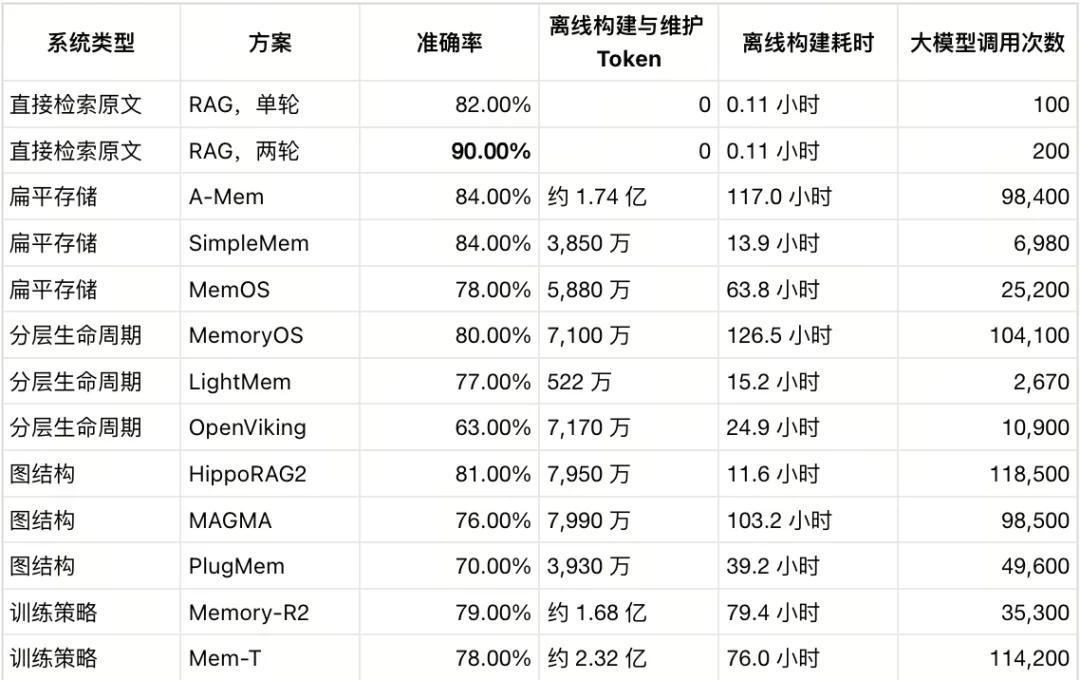
(注:表中成本是这 100 组语料的累计消耗。RAG 的零 Token,指没有用大模型提前构建和维护记忆;向量化、索引、存储、检索、重排和回答仍然需要资源。)
最终,这组测试中,11 个记忆系统中,只有 A-Mem 和 SimpleMem 超过单轮 RAG,领先幅度都是 2 个百分点。而两轮 RAG 准确率则达到 90%,超过全部受测记忆系统。
模型换成 Qwen3.6-27B后,两轮 RAG 依然以 81.4% 的准确率继续领先这 11 个系统。
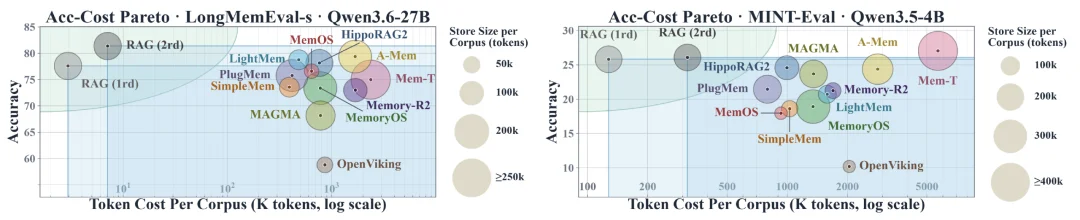
可以看到图中位置越靠左上, Token 消耗越低、准确率越高;圆圈大小代表存储内容的 Token 数。左图里,两轮 RAG 比全部记忆系统更省,准确率也更高。右图中,Mem-T 略高于 RAG,但消耗明显增加。
论文中,作者搭建 RAG时, 没有暴力地把整段对话扔进向量库,然后直接做相似度搜索。而是为它配置了一条完整的检索链:
此外,作者还会进一步让模型判断第一轮证据是否足够;不够时再发起一次检索。获得更多信息的同时,也带来了更多的在线模型调用成本。
以上这些优化显著提升了RAG的最终检索准确率,在 LongMemEval-s、Qwen3.6-27B 的消融中,只是结合BM25与稠密向量再做一轮重排,就可以把准确率从72.6%提升到77.6%。完整结果展示如下:
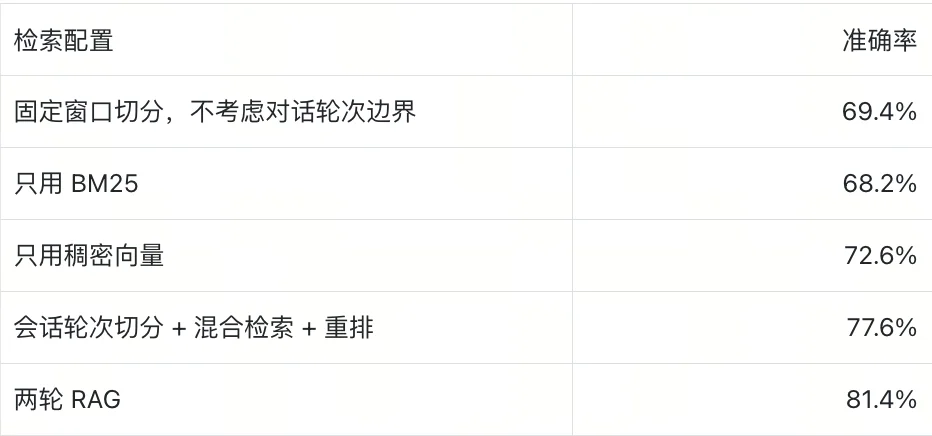
注:在 Milvus 中,同一份对话片段可以同时用于稠密向量检索和 BM25 全文检索:向量提供语义匹配,BM25 补充查询词的匹配。两路候选融合后,再由应用调用模型重排,原文、会话 ID 和时间等信息则随片段一起保存。
记忆系统通常先整理历史,再等待用户提问。但问题在于处理时,它还不知道下一次问题需要哪些细节。
这就导致有些信息在加工时就已经丢失,也有些信息虽然还保存在记忆中,但在加工后反而更难被找到。
关于细节丢失的情况,研究者从三个基准中抽取了 500 条原始对话轮次,检查对应记忆的信息保留情况。OpenViking 完整保留信息的比例为 39.4%,另有 38.0% 的轮次找不到对应记忆单元;SimpleMem 和 Memory-R2 的完整保留比例分别为 65.6% 和 72.6%。具体体现为:
用户提到从机场打车去酒店大概需要60 美元,觉得有些贵。OpenViking 把它概括成用户偏好高性价比交通方式,具体金额消失了。后来如果问坐火车能省多少钱,这条记忆就不够用了。
用户在 1 月 24 日说刚开始使用新双肩包,包裹在 1 月 20 日送达。SimpleMem 将其记为 1 月 20 日开始使用,把到货时间和启用时间混在了一起。
用户要求忘掉自己收藏古董地图的事。MAGMA 将这条请求改写成一条关于“忽略收藏偏好”的记忆,后续推荐书房装饰时仍然提到了古董地图。
关于信息被加工后检索不到的情况,实验中,研究者发现MAGMA 在抽检中完整保留了 93.6% 的原始信息,但常规问答准确率只有 68.2%。研究者跳过检索,直接把包含正确证据的记忆单元交给模型,准确率升至 84.4%,接近直接提供原始证据时的 84.6%。也就是说,信息还在,只是检索没有把它们找出来。
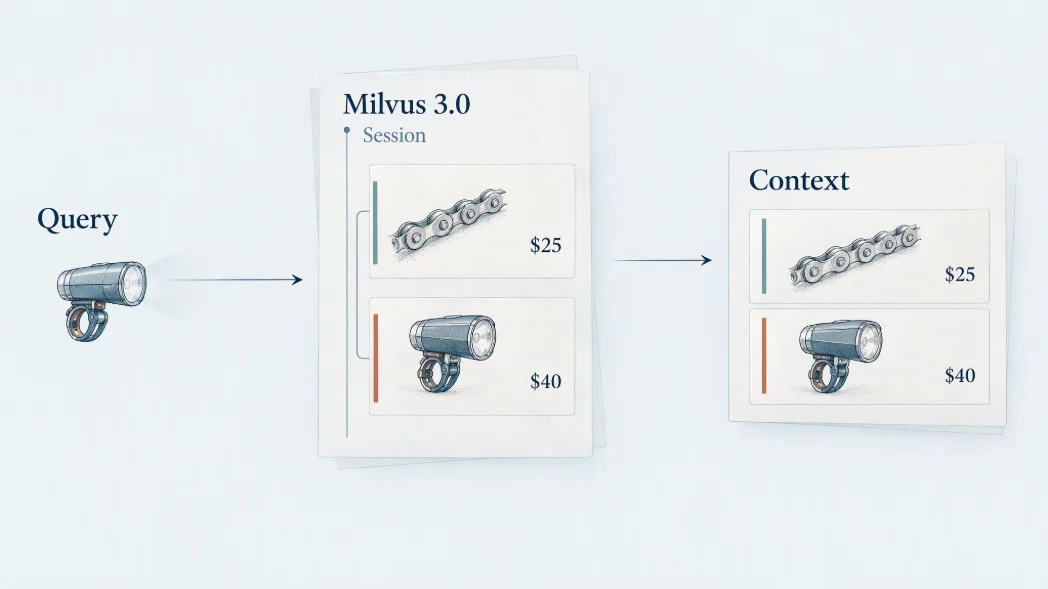
问题可能出在记忆的粒度。例如,用户在一段话里提到修自行车链条花了 25 美元、装车灯花了 40 美元。LightMem 将它们拆成独立记忆;后来查询今年的修车总开销时,第一轮找到了车灯,修链条成本却直到第四轮才出现。
反过来,切得太大也可能有问题。论文中,OpenViking 将“单程通勤 45 分钟”放进一份很长的用户画像,周围混有大量其他信息;当问题只针对通勤时间时,这个细节反而不容易被检索出来。
注:针对无法找到最后chunk大小的情况,我们不妨利用Milvus 3.0 的 StructArray,在建库时把片段和会话的关系保留下来。例如,以一次会话作为实体,记录会话 ID、时间和原文;链条、车灯等片段连同各自的向量,放在这个会话实体下。这样,检索命中车灯片段后,应用可以利用会话信息,进一步读取同一次会话中的相关内容,再让模型判断哪些费用应该计入。
前面说了这么多,并不是说两轮 RAG 一定是实践中最优解。因为它将更多计算放到了查询时,会增加在线调用和等待时间。
Agent Memory带来的也并非全部都是负优化。因为记忆系统可以通过提前整理历史,可以让后续回答更快捷。尽管在这些实验里,提前投入大量计算,并没有带来相应的准确率优势。
为了幕布这个问题,论文第 6 节,作者做了一项改动:检索记忆的同时,也检索原始历史,将两边候选合并、联合重排,再交给模型回答。
最终表现如下:
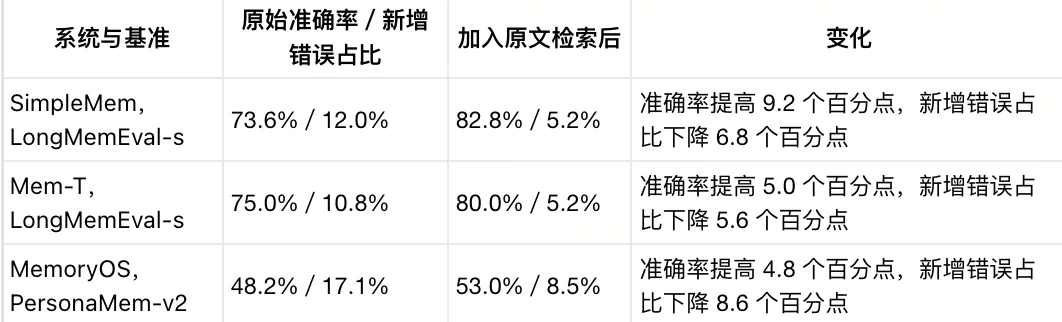
可以看到三组结果中,准确率都提高了,原本能答对、引入记忆后反而答错的问题也减少了。SimpleMem 的准确率也从 73.6% 升至 82.8%,提升了 9.2 个百分点。
这项改动保留了原有记忆,同时让原始证据重新参与回答。原本在摘要中可能漏掉的金额或日期,通过原始会话索可以得到补全。
论文地址:https://arxiv.org/pdf/2610.34073
Zilliz黄金写手:尹珉
文章来自于"Zilliz",作者 "尹珉"。

【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
