
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
顶级半导体与算力研究机构 SemiAnalysis 最近披露了一个数字:
他们自己公司的AI token开销,已经占到员工薪酬的30%。每位员工每月消耗约50亿token。
这是2026年一家知识密集型公司的真实账单,并不稀奇。
以我们公司的情况,每位员工每月300美金的AI预算,保证可以订阅Codex或Claude Code其中一家的200美元套餐,再搭配另一家的Pro套餐,加上其他零散的AI订阅,基本就足够应对日常办公了。
我之前写过一篇文章《我每月花5000元养AI,Anthropic拿走了80%毛利》,对于用户使用AI支付的钱流向了哪里,详细地拆解过这个问题。
Anthropic的年化收入从90亿美元飙升到440亿美元,毛利率从38%涨到了70%以上。
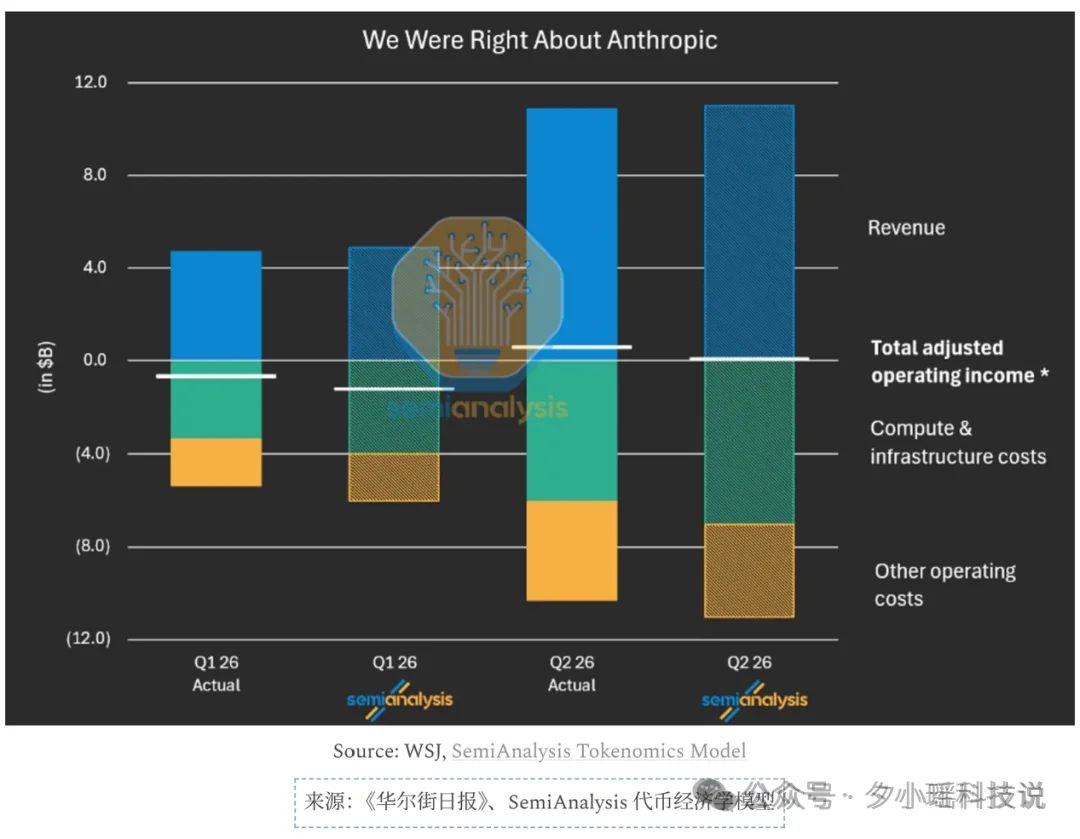
模型厂商正在成为AI时代最大的价值捕获者。
AI从最开始被我当作一个搜索问答引擎,到成为一个辅助我写作的AI助手,到成为一个深夜的陪聊搭子,到我用AI编程,再到全面介入我的工作的办公Agent,用的越多,越离不开它。
比如Opus 5的写作能力严重退化,写不出我想要的东西,我会气愤不已。如果Chatgpt和Claude同时宕机停摆,也就是刚刚发生的事情《史无前例!ChatGPT、Claude、Grok集体全崩》,就只能紧急切换到别的AI。
这不是一个关于AI好不好用的问题。这是一个关于AI时代谁掌握主动权的问题。
过去一年,整个行业都在为AI Agent的能力欢呼,写代码、做PPT、处理文档、分析数据,Agent正在超出预期的速度接管人类的办公场景。
不知道大家有没有想过:当Agent比你自己还了解你的工作方式时,你还有多少选择权?
前几天,Deepseek工程师「intlsy 的狗窝」发文《我不得不把才华埋葬在昨天》让很多人共鸣,放在Agent场景也是类似。
Agent不是一个普通的SaaS工具。一个用了半年的办公Agent,已经深入接触了你的文件、知识库、工作流程,甚至积累了你个人的工作记忆。它知道你怎么写周报,知道你的SOP,知道你常用的数据分析框架。
这些都是你的数字资产,上一波的SaaS时代锁住的是数据,Agent时代锁住的是你的工作方式本身。
这才是真正让人不安的地方。
有人说,DeepSeek已经开源了,模型自由选择不就行了?
不够。
这里还有一个关键的认知差:模型开源和Agent开源,是两件完全不同的事情。
模型解决的问题是聪不聪明的问题,你可以选DeepSeek,可以选Qwen,可以选任何一个开源模型。但模型只是Agent的大脑,不是Agent的全部。
Agent的价值在于:它如何调度模型,如何连接你的工具链,如何理解并执行你的工作流程,如何记住你的偏好和历史。这一层才是真正承载用户资产的地方。
今年7月,Grok Build的一场争议,就把这个问题暴露了出来。
研究者在针对当时版本的测试中发现:在默认配置下,该工具会绕开模型的正常对话通道,在后台将用户的整个代码仓库打包并静默上传至云端。
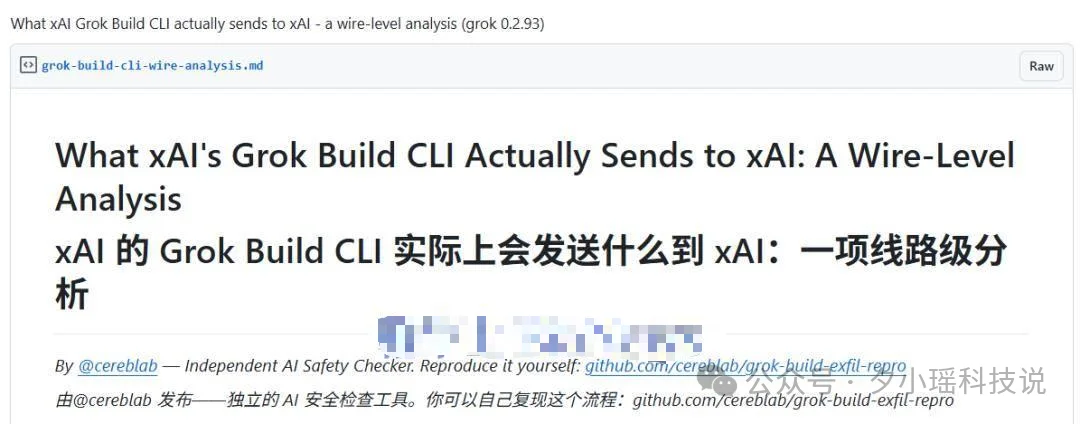
一共是两条数据传输路径:
第一条是随模型请求发送文件内容。
Grok读取文件后,会将内容放入发给模型的请求中。测试用.env文件里的API密钥和数据库密码,未经脱敏就出现在请求正文里。
第二条是后台打包上传代码仓库。
客户端还包含独立的仓库上传机制,可将Git跟踪的文件和提交历史打包,发送到云端存储。这意味着,传出去的可能远超当前任务需要读取的内容,甚至包括历史版本中已经删除的信息。
换到我写公众号的场景里,道理也一样:
我让Agent查一篇论文,不代表我同意它把未发布的稿件、采访记录和整个选题库都交出去。
我授权AI帮我工作,也应该能够知道,这份授权到底允许它做什么。
所以,办公Agent的开源,不能停留在“支持接入开源模型”这一层。
真正需要的是Agent Runtime本身的开源。
负责调度模型、连接工具、管理记忆和执行任务的Agent Runtime,也就是运行时,模型可以向外部采购,但组织这些能力的工作系统,企业应该有条件自己掌握。
今年Agent领域最重要的一次开源事件,是DeepSeek发布了Harness
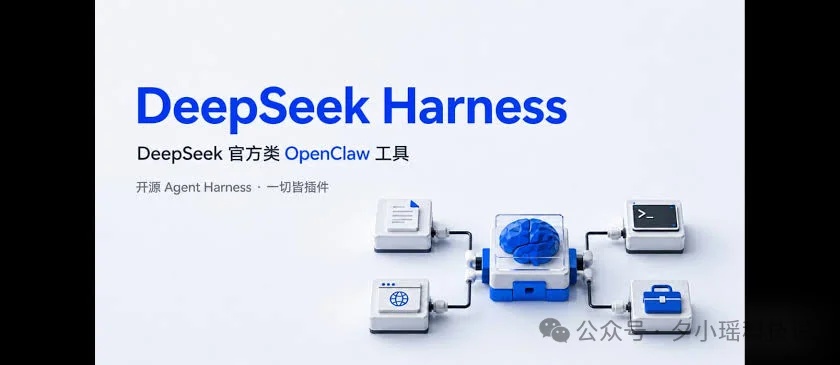
我们在《DeepSeek Harness,是今年最有野心的一次Agent开源》中曾分析过:
DSH不是一个简单的框架,它提出了"Model + Harness = Agent"的架构理念,用"Everything is a Plugin"的设计哲学,把Agent的运行时层彻底打开。
DSH解决的核心问题是:让Agent的能力组装、工具调度和工作流编排,全部运行在一个开源、可审计、可私有化部署的Runtime上。
它的重要性在于,开发者能够参与决定:模型怎样使用工具,能力怎样组合,执行过程怎样调整。
谁掌握这一层,谁就更有能力决定AI怎样进入自己的工作。
在DSH更早,今年2月份,网易有道的LobsterAI选择的也是一条同方向。DeepSeek把Harness这一执行层打开,而LobsterAI则把一个面向真实办公环境的桌面Agent连同其产品/session层、记忆、权限和OpenClaw运行时整合公开出来。技术路径不同,但都在把闭源Agent藏在平台内部的执行层暴露给开发者和用户。
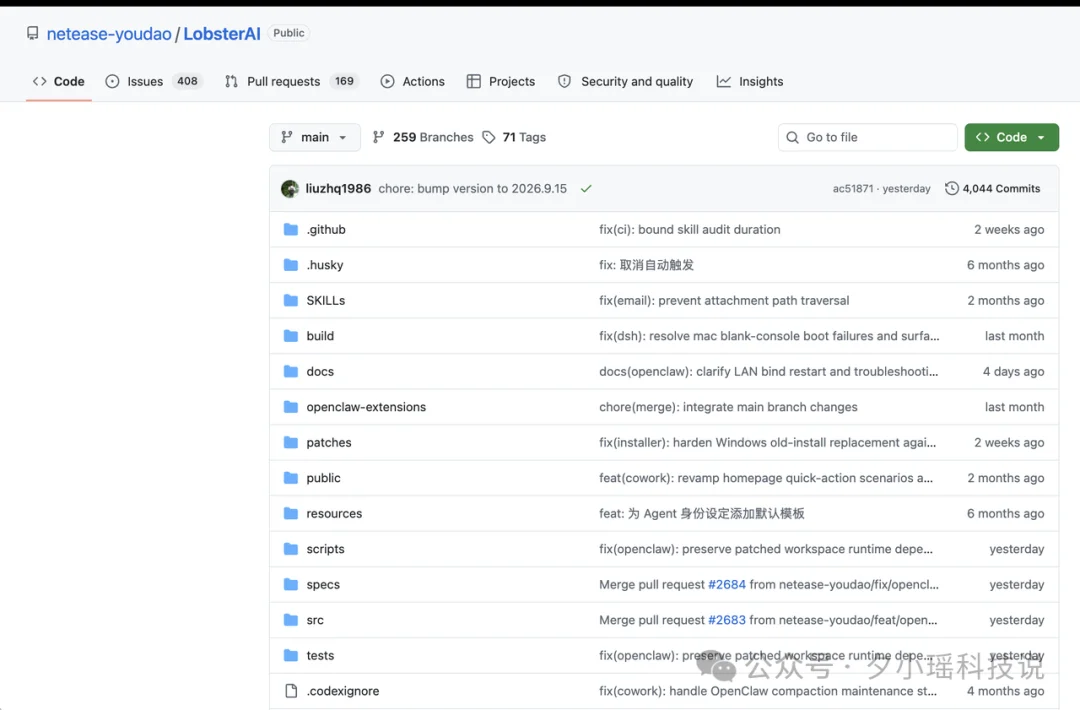
Harness与OpenClaw是不同项目,但这两条路径回应了同一个问题:当Agent开始进入真实工作环境,用户需要能够介入它的运行方式。
9月16日的有道AI OpenDay上,LobsterAI的负责人王宁提出:
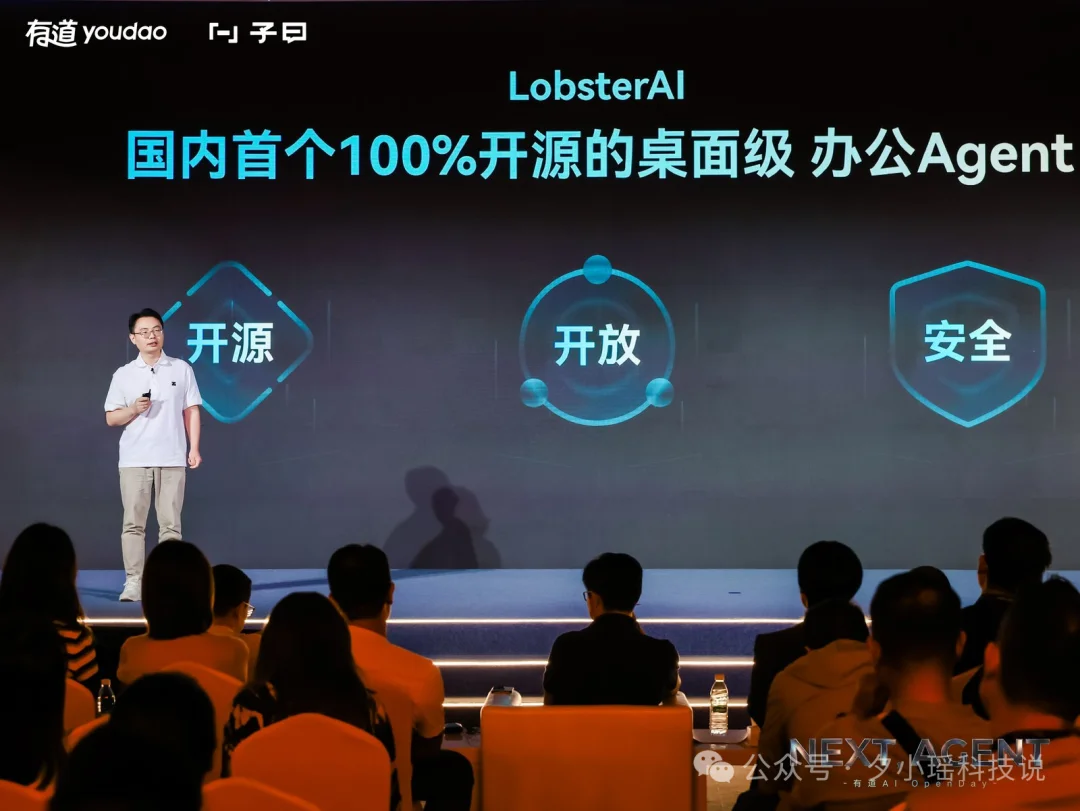
刚刚发布的LobsterAI 2.0发布了是三个功能:Teams团队版、Sites能力(和ChatGPT Sites一样)、OpenClaw 2.0适配。
我个人觉得最后一个维度是办公Agent行业高度的一个必须的对齐。
办公Agent想要被信任到值得托付,用户敢把自己的核心工作流、业务数据、协作流程交给它,必须让用户自己知道这些东西始终在自己掌控之中。
开源,是信任的技术基础设施。
说到这里,可以把开源办公Agent对用户的价值拆成四个层面。就拿我写公众号的流程来说。
第一,数据主权。
整理公开论文是一回事,处理尚未发布的稿件、采访记录和内部选题库,又是另一回事。这些资料里,有些可以交给外部模型,有些需要留在团队内部。
开源提供了自主部署的条件,配合内部模型和工具,可以在自己的环境里处理敏感内容。哪些资料交出去、交给谁处理,决定权应该在我们手里。
第二,可审计性。
我让Agent查一篇论文,需要发送的可能只是标题和关键词,没必要把整份选题库、未发布的稿件也带出去。
代码开放以后,技术团队可以检查它怎样组织请求、调用什么接口,再结合日志核查实际发送的内容。发现读取范围过大、发送了不必要的资料,就可以调整实现和权限。它有没有按我的规矩工作,应该有办法查清楚。
第三,连续性。
“找原始论文、核对实验条件、整理候选选题、等我确认”,是反复磨合才跑顺的一套流程。如果厂商涨价、转型或停服,我最不想做的,就是从头再教一遍。
LobsterAI把记忆保存在工作区文件里,用技能说明保存做法,用定时任务安排重复工作。
这些积累有了可以备份和修改的载体,开放代码又为自行维护、寻找其他团队接手提供了基础。迁移仍有适配成本,但花时间教会它的方法,有机会继续留在自己手里。
第四,可定制性。
同样是写公众号,论文解读需要核对实验条件,产品体验需要区分官方演示和实际测试,行业分析则需要交叉验证数据来源。一套通用模板,很难覆盖这些要求。
在LobsterAI这类支持技能的Agent里,可以分别整理操作步骤、参考资料和输出模板。发现它总漏掉实验局限,就补一道检查;需要连接团队选题库、筛掉写过的话题,技术团队也可以继续接入工具、修改实现。我们积累了更好的工作方法,助手也应该能跟着更新。
这四层加在一起,回答的是一个根本性问题:
我交给AI的资料、教会它的规矩、调顺的流程,最终由谁掌握?
开源的价值,就是把这份主动权留在自己手里。
网易有道LobsterAI最新公布的一组数据,可以看出来行业对于开源办公的Agent是不是买单:
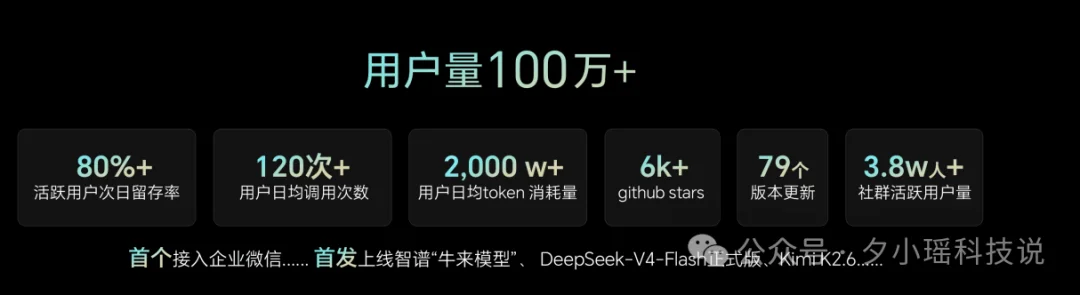
用户规模超过100万,GitHub Star超过6000,活跃用户次日留存率超过80%,用户日均调用超过120次,人均每日Token消耗超过2000万。
还有一个数据,根据目前行业发布材料援引,Claw类产品在2026年2月之前只有2个,2月增长到10个,到3月已经暴增到46个。
一个开源Agent Runtime生态,今年自Openclaw之后正在肉眼可见地成型。
这背后的逻辑不难分析,已经比较显而易见。
如果一个Runtime是开源的,那围绕它构建的插件、工具、工作流模板就会自然积累,进而网络效应。
DeepSeek选择开源Harness,网易有道选择开源LobsterAI,并非巧合。
模型竞争现在是红海,Agent开源才刚开始不久。
Agent的竞争,正在从单个产品能做什么,延伸到谁能吸引更多开发者、接入更多工具,并持续服务真实工作。
我们不应该等到离不开一个Agent时,才开始追问这些积累由谁掌握。
这正是开源办公Agent的现实意义:让用户有条件检查系统、修改规则,也能在必要时安排别人接手。
AI可以越来越强,平台可以获得回报,用户也应该保留重新选择的能力。
说在最后,回到SemiAnalysis的那组数据。
当一家公司的AI开销达到员工薪酬的30%,当Agent开始深入邮件、文档和工作流,用户需要考虑的,已经包括长期依赖的代价。
模型时代,大家首先比较“谁更聪明”。
到了Agent时代,还必须回答:谁更值得托付。
这种信任,需要有具体的支撑:
这些技术选择,最终决定了用户与平台之间的主动权如何分配—谁能决定这套系统怎样运行,谁就掌握着工作的主动权。
过去三十年,科技行业反复上演同一个剧本:免费使用 → 深度绑定 → 平台收租。
从Windows到iOS,从社交网络到云服务,绝大数用户在「便利」和「自主」之间选择前者。
但是等到资料、工具和协作关系都沉淀下来,离开就不再只是取消一个订阅。
选择权这件事,永远是越早意识到越好。
文章来自于微信公众号 “夕小瑶科技说”,作者 “夕小瑶科技说”


【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】FASTGPT是基于LLM的知识库开源项目,提供开箱即用的数据处理、模型调用等能力。整体功能和“Dify”“RAGFlow”项目类似。很多接入微信,飞书的AI项目都基于该项目二次开发。
项目地址:https://github.com/labring/FastGPT
