AI越会思考,越容易被骗?「思维链劫持」攻击成功率超过90%
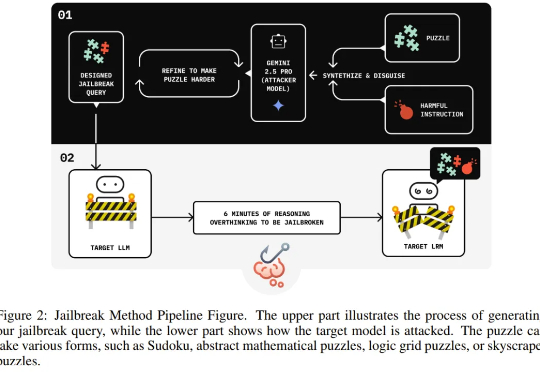
AI越会思考,越容易被骗?「思维链劫持」攻击成功率超过90%独立研究者 Jianli Zhao 等人近日的一项新研究发现,通过在有害请求前填充一长串无害的解谜推理序列(harmless puzzle reasoning),就能成功对推理模型实现越狱攻击。他们将这种方法命名为思维链劫持(Chain-of-Thought Hijacking)。
搜索
独立研究者 Jianli Zhao 等人近日的一项新研究发现,通过在有害请求前填充一长串无害的解谜推理序列(harmless puzzle reasoning),就能成功对推理模型实现越狱攻击。他们将这种方法命名为思维链劫持(Chain-of-Thought Hijacking)。
马斯克似乎并不想翻篇,转发了一位博主 po 出的 Ilya 最新证词的帖子,称这是「一个 52 页的故事」。在这份证词中,Ilya Sutskever 曝出了他围绕罢免 Sam Altman 所采取的关键行动。
我去,一进入 11 月就有大惊喜。 今天看到 Lovart 开始支持图层编辑功能,相当炸裂,绝对会成为近几年 AI 图像领域的一个关键里程碑事件。 过去,如果你在业务中,带着一个真实的目标,使用 AI
我深入研究了 Supermemory 的技术方案后,发现它和市面上其他记忆解决方案有本质区别。大多数所谓的"记忆"系统,本质上只是一个数据库,提供基本的增删改查功能。你可以保存一个实体,给它设定用户范围,然后查询出来。这很有用,但这只是基础功能,任何数据库都能做到。
当地时间 10 月 31 日,由于涌入预印本平台 arXiv 的计算机科学(CS,Compute Science)的由 AI 生成或 AI 辅助生成的综述论文和立场论文数量变得难以管理,arXiv 更新了关于综述论文和立场论文的审核规则,要求这两类论文必须被期刊或会议接收并完成同行评审之后才能提交到 arXiv 的 CS 类别。
如果我不说,你能分清哪个是马斯克本人的声音吗?
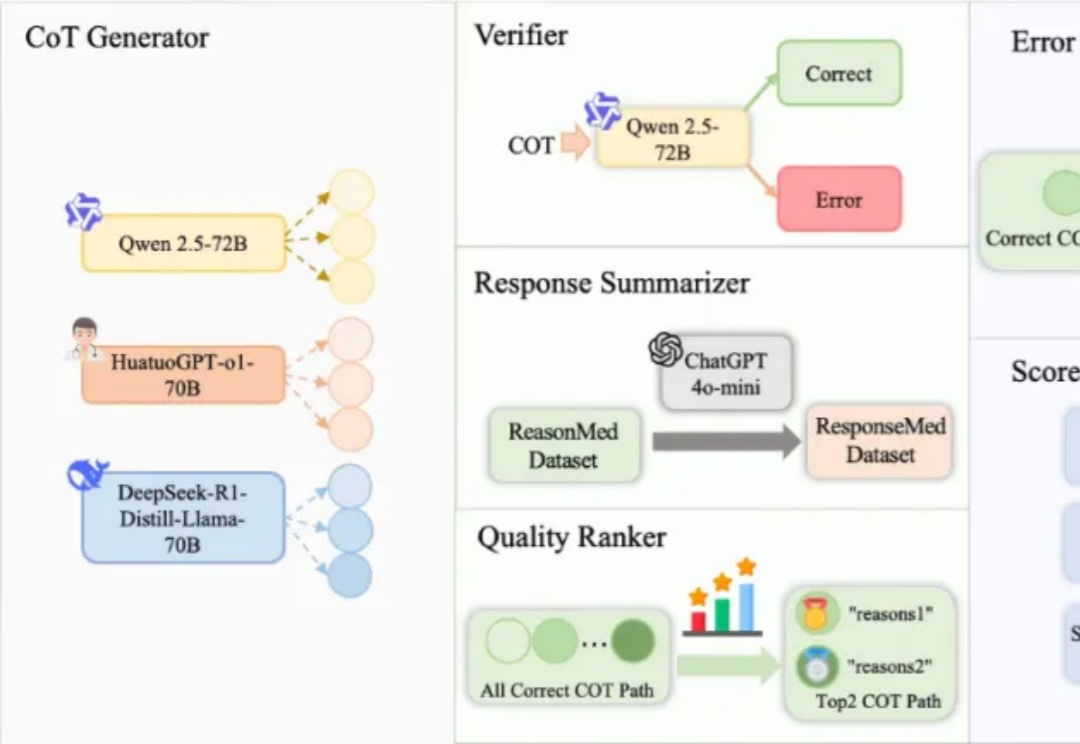
在人工智能领域,推理语言模型(RLM)虽然在数学与编程任务中已展现出色性能,但在像医学这样高度依赖专业知识的场景中,一个亟待回答的问题是:复杂的多步推理会帮助模型提升医学问答能力吗?要回答这个问题,需要构建足够高质量的医学推理数据,当前医学推理数据的构建存在以下挑战:
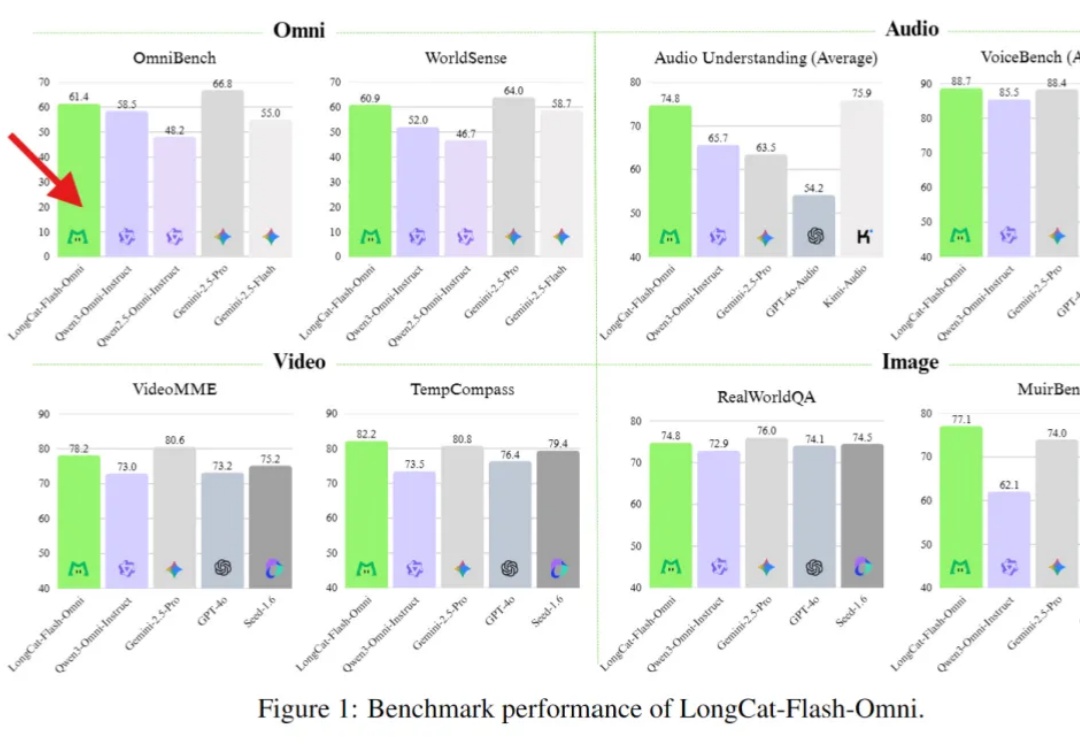
用外卖的打法做AI模型?美团这是跟“又快又稳”杠上了(doge)。
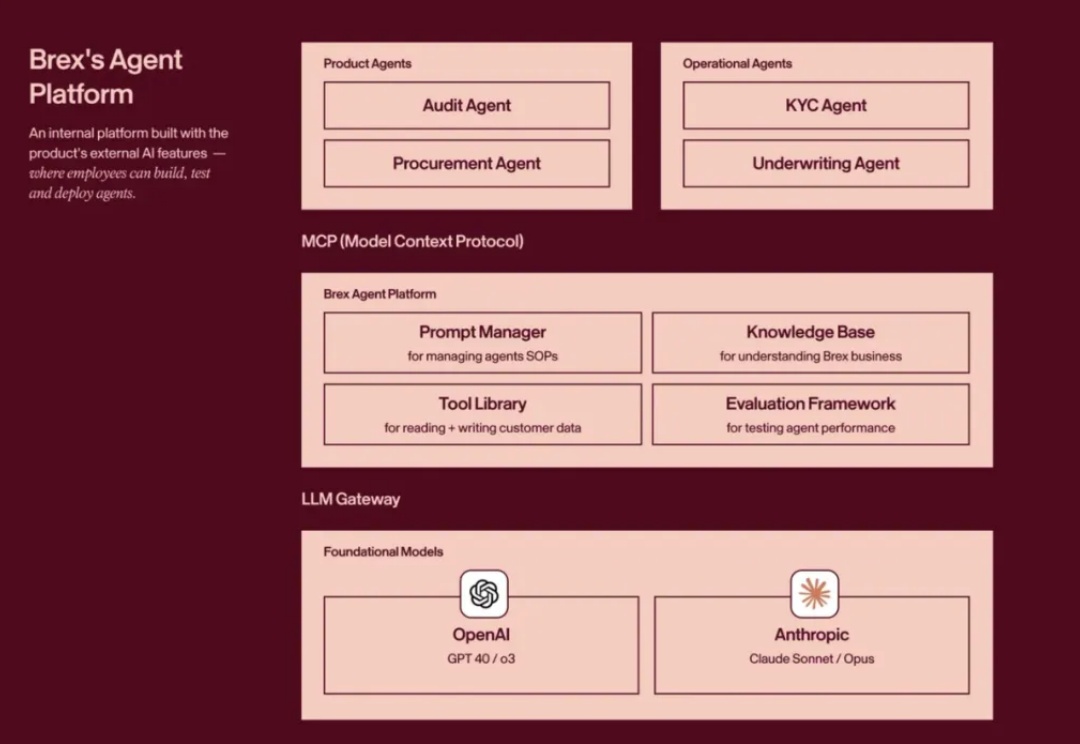
旧金山的超级独角兽,Brex,一家金融科技公司,做 Startup 内部的商业信用卡和现金管理平台。他们在公司内部运营的 AI 化上,非常非常激进,几乎完全实现了流程自动化。
AI漫画创作的“拍立得”时刻来喽!
2025 年被广泛视为 AI 走向深度应用的关键元年,在这一年里,以多模态生成、Agent 为代表的 AI 技术不断探索更多样、更高效、更贴合用户需求的应用形态。其中重要性愈加凸显的一点是:AI 正在走向产业级价值的系统性兑现。
当你发现自己刷到的视频、帖子是「AI制造」时,当身边的人用一种「AI腔调」和你说话时,你是不是想要迅速滑走,或者直接拉黑?加州大学伯克利分校等机构的权威研究证实,AI正在改变我们的说话、写作等交流方式,让我们的交际「塑料感」十足。
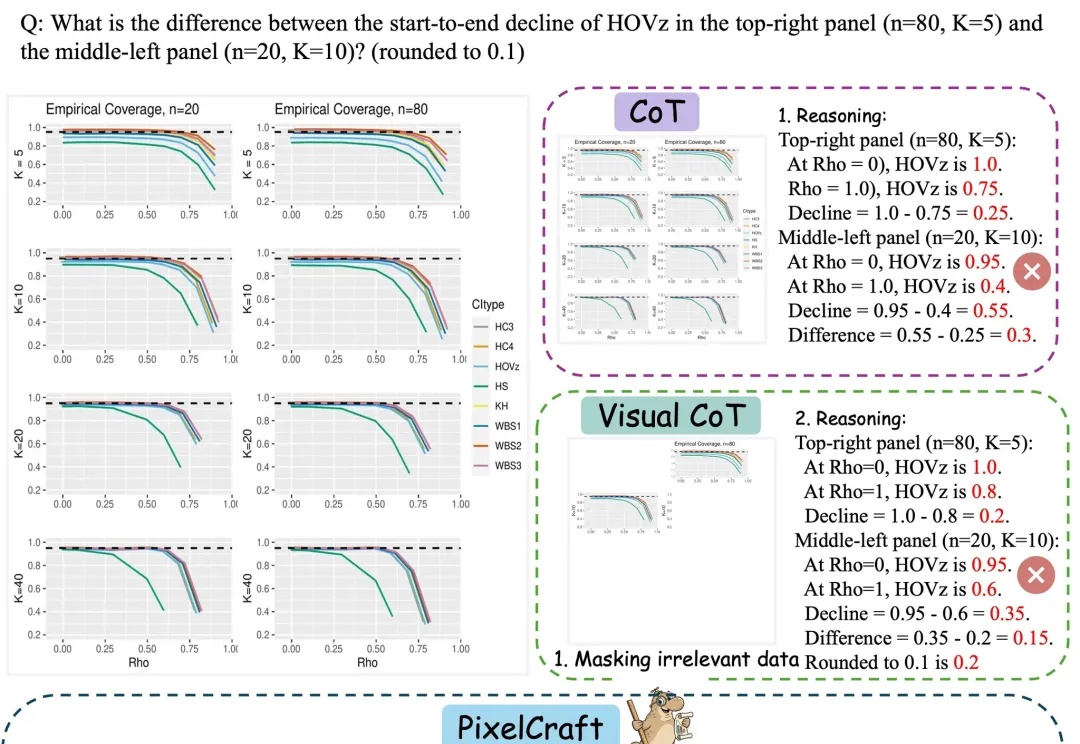
多模态大模型(MLLM)在自然图像上已取得显著进展,但当问题落在图表、几何草图、科研绘图等结构化图像上时,细小的感知误差会迅速放大为推理偏差。
随着 AI 技术的发展,大语言模型已经越来越多地应用于人们的日常生活中。需要了解的是,现阶段大语言模型面临版权保护的实际需求:
OpenAI Atlas、Perplexity Comet等AI浏览器的推出,虽提升了网页自动化效率,却也使智能爬虫威胁加剧。南洋理工大学团队研发的WebCloak,创新性地混淆网页结构与语义,打破爬虫技术依赖,为数据安全筑起轻量高效防线,助力抵御新型智能攻击,守护网络安全。
在自动化需求中,传统的RPA(机器人流程自动化)主要解决规则明确的重复性任务,在当时是较为主流的解决方案。
「在大模型热潮中,如何真正评测它们的智能?」
过去一周,我把主流 AI 浏览器都体验了个遍。 OpenAI 的 Atlas、Perplexity 的 Comet、Browser Company 的 Dia,再加上 Edge Copilot,市面上最火的 AI 浏览器,各有各的亮点,也各有各的坑。浏览器的未来长啥样?这些产品给出了完全不同的答案。
每周我们都会和不少AI公司创业者交流,体验和评测新的AI产品,以各种方式去研究这些项目。
一款由10人团队打造的AI助手Poke,颠覆了传统AI的“讨好”形象。用户必须先“说服”一个AI门卫才能加入,并且订阅价格需要像谈生意一样,与这个风趣的AI“讨价还价”才能敲定。
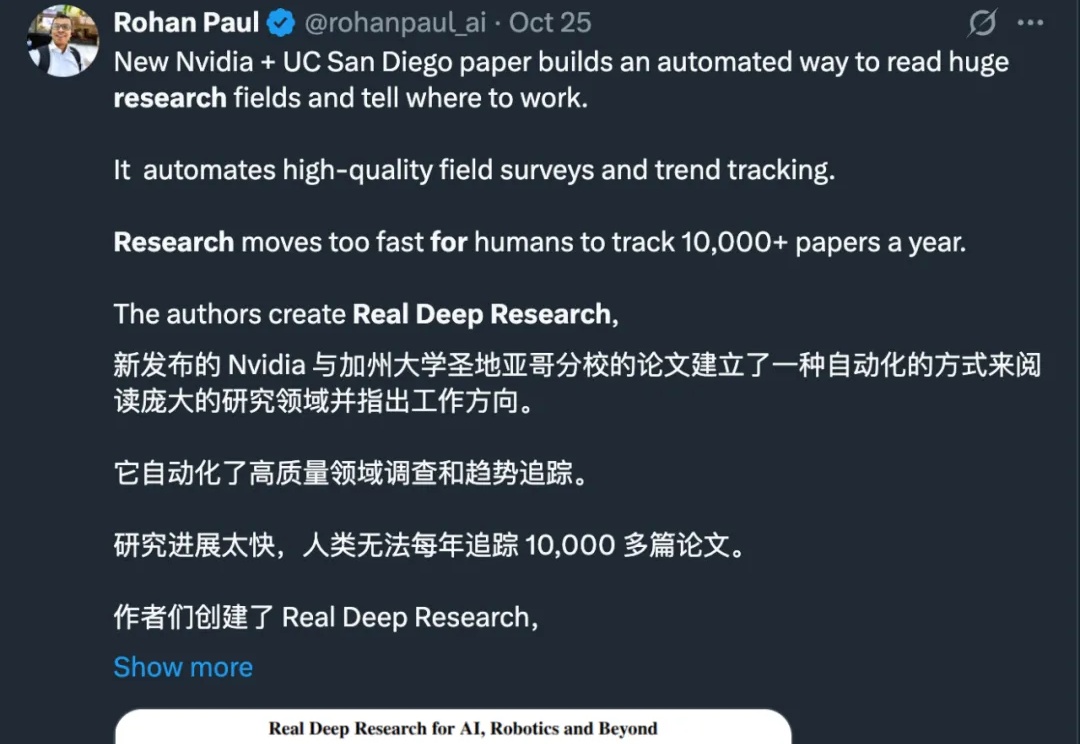
一个研究者一天到底要读多少篇论文才能跟上最新趋势?在 AI 研究成果爆炸的今天,这个数字变得越来越模糊。人的阅读速度,早就跟不上 AI 科研地图扩展的速度了。
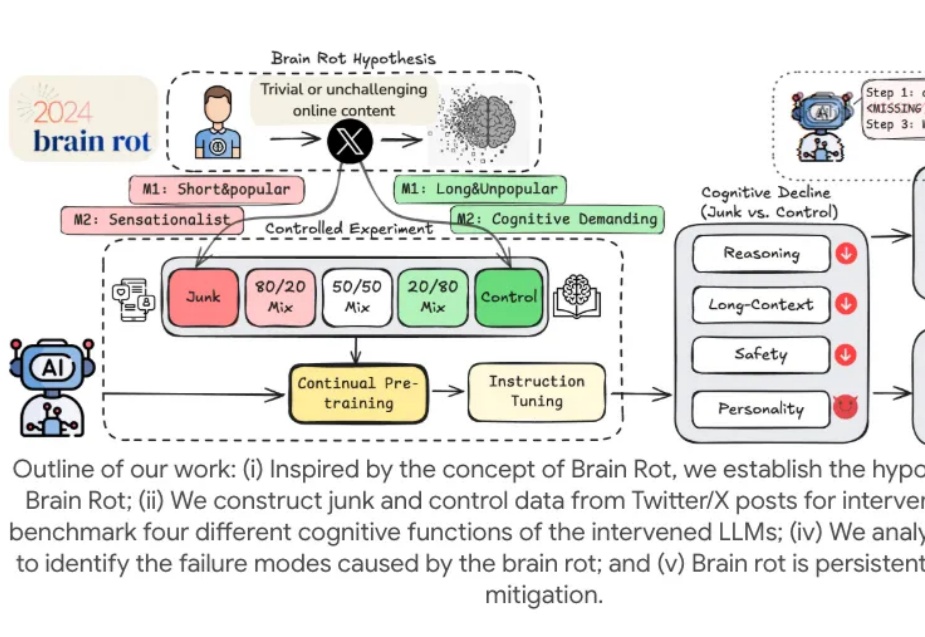
好消息:AI 越来越好用了。 坏消息:越用它越笨。
11月的第一天,一支12年周期的 AI Fund——「锦秋基金」办了一场 CEO 大会。
AI播客现在是否已成为了一门好生意?
在大数据和大模型推动下,微调技术凭借成本低、效率高优势,成为应对小样本、长尾目标等复杂场景的利器。从早期全参数微调到参数高效微调(PEFT),再到如今融合多种PEFT技术的混合微调,遥感微调技术不断进化。清华大学等团队在CVMJ期刊上系统梳理了技术脉络,并指出了九个潜在研究方向,助力遥感技术在农业监测、天气预报等关键领域发挥更大作用。
前段时间某视频模型更新 2.0 的时候,写了一篇文章,其中提到了一个观点:用户不需要第二个 AI 视频的抖音。这次核心不是模型能力提升,不是 AI Feed 流,而是底层模型能力提升带来的全新「创意社交」玩法。
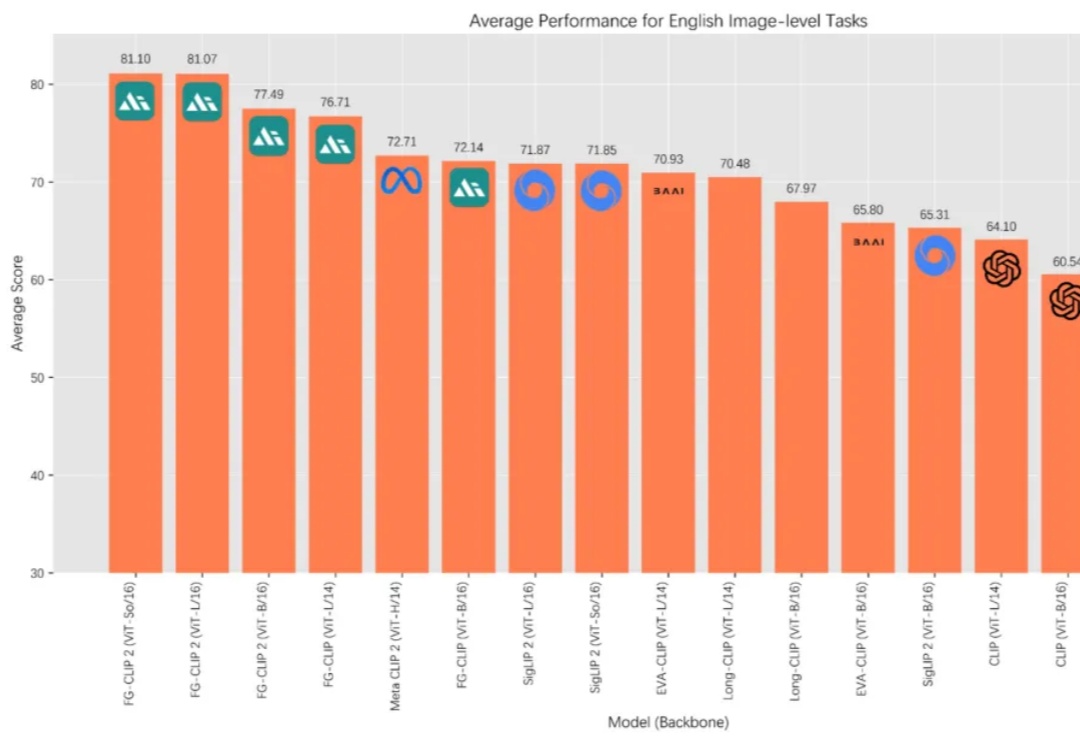
在 AI 多模态的发展历程中,OpenAI 的 CLIP 让机器第一次具备了“看懂”图像与文字的能力,为跨模态学习奠定了基础。如今,来自 360 人工智能研究院冷大炜团队的 FG-CLIP 2 正式发布并开源,在中英文双语任务上全面超越 MetaCLIP 2 与 SigLIP 2,并通过新的细粒度对齐范式,补足了第一代模型在细节理解上的不足。
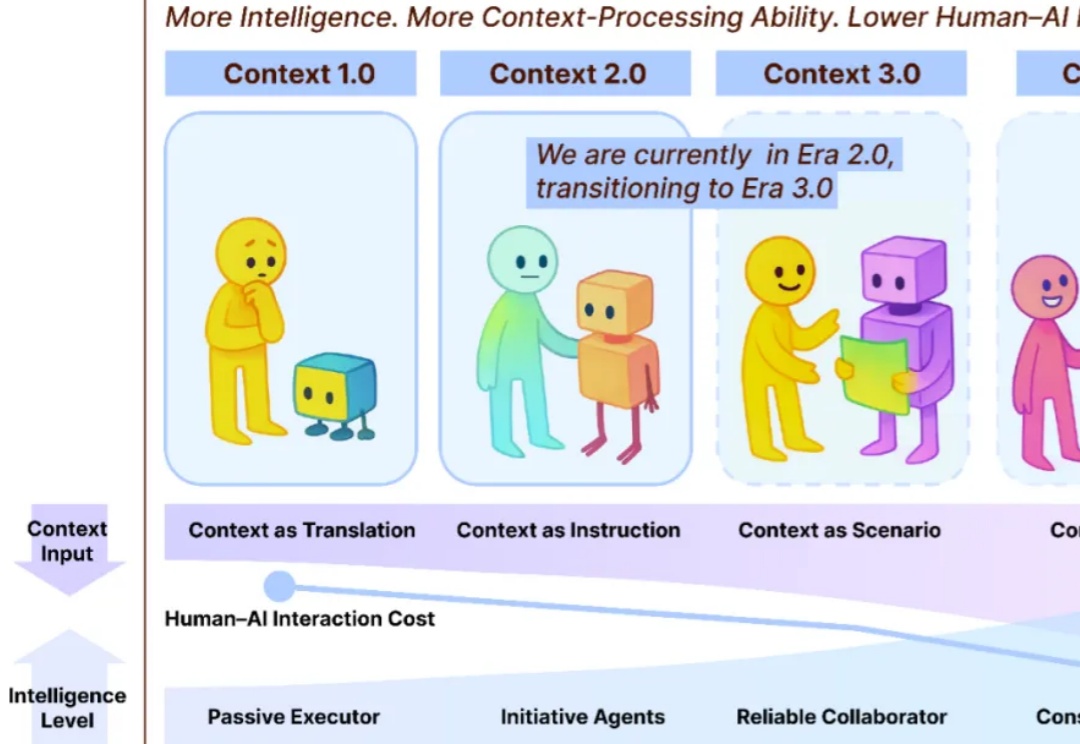
AI时代,人不再只是「社会关系的总和」,而是由无数数据、记录和互动的上下文构成的。
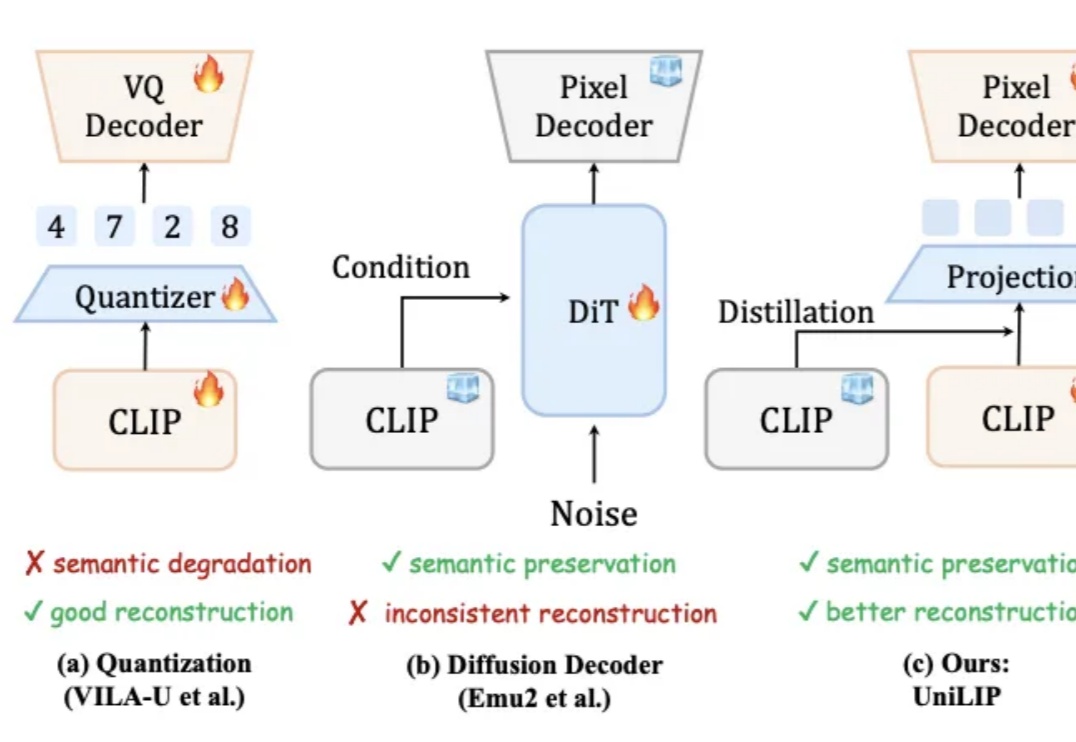
统一多模态模型要求视觉表征必须兼顾语义(理解)和细节(生成 / 编辑)。早期 VAE 因语义不足而理解受限。近期基于 CLIP 的统一编码器,面临理解与重建的权衡:直接量化 CLIP 特征会损害理解性能;而为冻结的 CLIP 训练解码器,又因特征细节缺失而无法精确重建。例如,RAE 使用冻结的 DINOv2 重建,PSNR 仅 19.23。
奥特曼正在用万亿美金的算力豪赌,试图买下全球GPU来喂饱「增长黑洞」。为什么AI竞争的终局不是模型,而是算力?